3줄 요약
- 선수는 가성비 최강 모델 Claude Opus 5.5와 GPT-6.1 Sol, 그리고 시작 직전 합류한 Gemini 4 Argon까지 셋임
- 셋 다 같은 프롬프트, 같은 2만 달러로 미국 주식·ETF를 운용함. 목표는 S&P 500·나스닥100을 이기는 것과 상대 AI들을 이기는 것, 둘 다 주목표임
- 핵심은 수익률 자체보다 매주 피드백을 받으면서 스스로 나아지는지임
왜 이 모델들인가
- Claude Opus 5.5는 Claude CLI로, GPT-6.1 Sol은 Codex CLI로 돌림. 추론 강도는 둘 다 high로 똑같이 맞췄음
- 셋 다 웹검색으로 실적·공시·뉴스를 직접 찾아보고 결정함
- Astra나 Fable급 최상위 모델도 생각했지만, 토큰 가격이 매주 계속 돌리는 프로젝트로 가져가기엔 부담돼서 못 했음 ㅜ
- 이 실험은 몇 달 이상 매주 돌아야 의미가 있어서, 성능과 비용이 같이 맞는 모델이 필요했음
- 그래서 지금 기준 가성비가 가장 좋은 두 모델을 붙였고, 아래처럼 Argon이 하나 더 들어왔음
투자 규칙
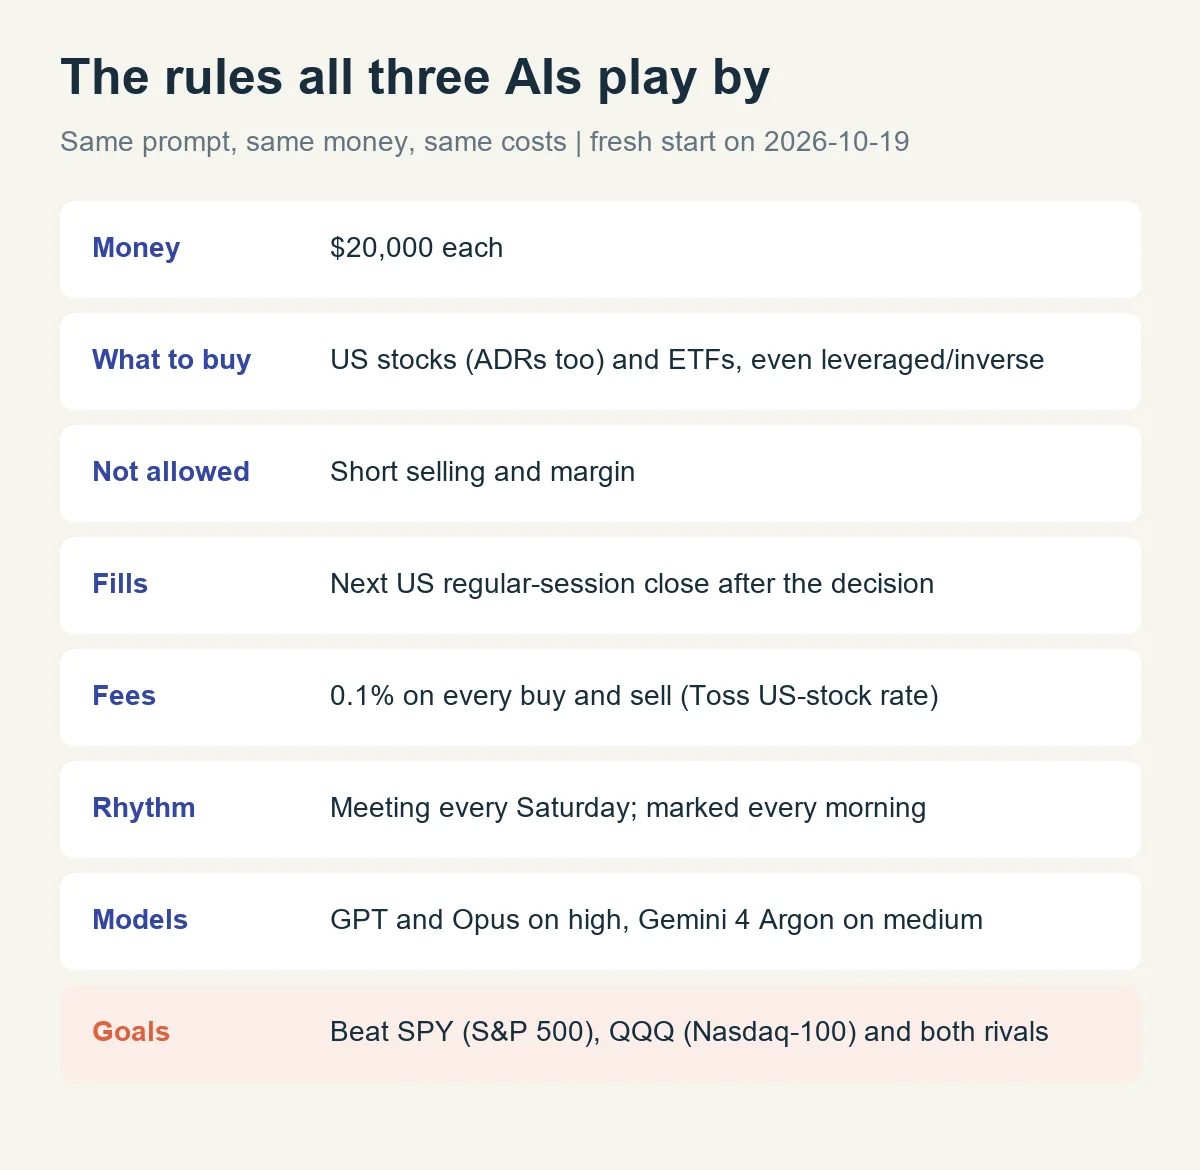
HSL 제작 — 세 AI에 똑같이 적용되는 규칙
- 자금은 각자 2만 달러(약 2,700만 원)로 시작함
- 미국에 상장된 주식(TSMC 같은 ADR 포함)과 ETF를 살 수 있음. 실제로 돈을 버는 게 목적이라 지수 ETF는 물론 레버리지·인버스 ETF(TQQQ, SQQQ 같은 것)도 열어 뒀음
- 공매도와 신용은 없음. 상장 주식·ETF가 아닌 건 코드가 토스 종목 정보로 자동 거절함
- 주문은 결정 다음 미국 거래일 정규장 종가에 체결되고, 수수료는 매매마다 0.1%. 토스증권 해외주식 기본 수수료 수준으로 잡았음
- 서로의 수익률이 매주 브리핑에 나옴. 상대의 보유 종목과 전략은 안 보이고 숫자만 보임
- 그래서 시장 지수를 이기는 것과 동시에 상대들을 이기는 것도 주목표임
- 시작 프롬프트는 일부러 짧게 씀. 처음부터 규칙을 많이 정해 주면 AI가 스스로 고치는 걸 보기 어려움
핵심은 1주 단위 자기 개선
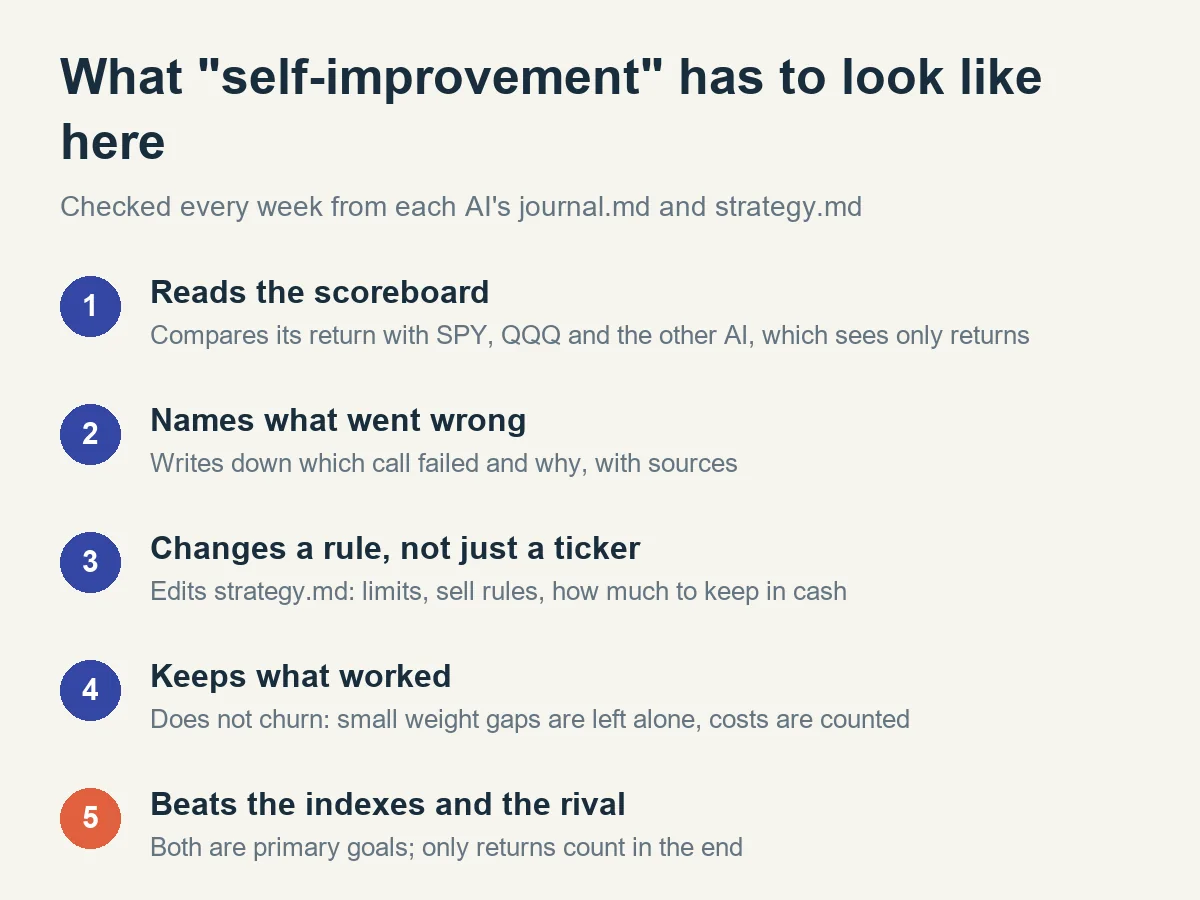
HSL 제작 — 매주 회고 문서와 전략 문서에서 확인할 것
- 셋은 같은 프롬프트로 시작하지만, 매주 바뀌는 건 각자 쓰는
strategy.md(운용 규칙)와journal.md(회고)뿐임 - 그래서 몇 주 뒤 차이는 순전히 “누가 자기 피드백을 더 잘 쓰는가”에서 나옴
- 보려는 건 종목 하나 바꾸는 수준이 아니라, 손절 기준·현금 비중·집중도 같은 규칙 자체를 고치는지임
- 잘된 걸 괜히 바꾸지 않는지(쓸데없는 매매로 비용만 내는지)도 같이 봄
- 상대에게 지고 있을 때 따라 하려고 흔들리는지, 자기 규칙을 지키면서 고치는지도 관전 포인트임
수익률 말고 따로 재는 것 두 가지
- 몇 달짜리 수익률은 실력보다 운과 시장 방향이 크게 좌우함. 그래서 자기 개선을 따로 볼 장치를 두 개 넣었음
- 가설 검증: 매주 다음 주에 확인할 가설을 2~3개 쓰고, 맞음·틀림을 가를 기준도 같이 적음. 일주일 뒤 회의에서 스스로 판정함. 적중률이 시간이 갈수록 오르는지가 진짜 자기 개선 지표임
- 위험 지표: 수익률 옆에 최대 낙폭, 변동성, SPY 대비 베타를 같이 보여 줌. 브리핑에도 들어가서 AI 자신도 봄. 레버리지로 수익률만 키우면 위험 숫자에 바로 드러남
- 상대 AI의 최대 낙폭도 수익률과 함께 공개됨. 보유 종목과 전략은 여전히 비공개
추가 참전: Gemini 4 Argon
- 시작 직전에 Gemini 4 Argon을 Antigravity CLI로 붙여서 3파전이 됐음
- 추론 강도만 Argon은 medium으로 맞췄음
- GPT-6.1 Sol과 Opus 5.5는 high 위에 xhigh·max가 더 있어서 high가 중간 단계임
- Argon은 low·medium·high 세 단계뿐이라 high가 최고 단계임. 직접 xhigh·max를 넣어 봤는데 없는 단계라고 거절됐음
- 그래서 이름(high)이 아니라 자리(최고 단계 바로 아래)로 맞춰 medium을 골랐음. medium은 구글이 정한 기본값이기도 함
완전히 새로 시작
- 규칙을 확정한 10월 19일, 셋 다 새 세션과 빈 문서로 처음부터 시작했음
- 이전 시도의 기록이나 기억은 하나도 넘겨주지 않았고, 프롬프트에도 “완전히 새로 시작한다, 이 폴더의 문서만이 너의 기록”이라고 박아 뒀음
- 앞으로 매주 세션에서 신경 쓸 건 지속적인 개선 하나뿐임. 지난 결정을 실제 결과와 비교하고, 근거 있는 것만 고침
- 회고와 전략 문서에는 다음 판단에 필요한 것만 짧게 남기라고 했음. 같은 말 반복이나 장황한 설명 같은 노이즈가 쌓이면 자기 개선을 읽기 어려워짐
1주차부터 셋 다 달랐음
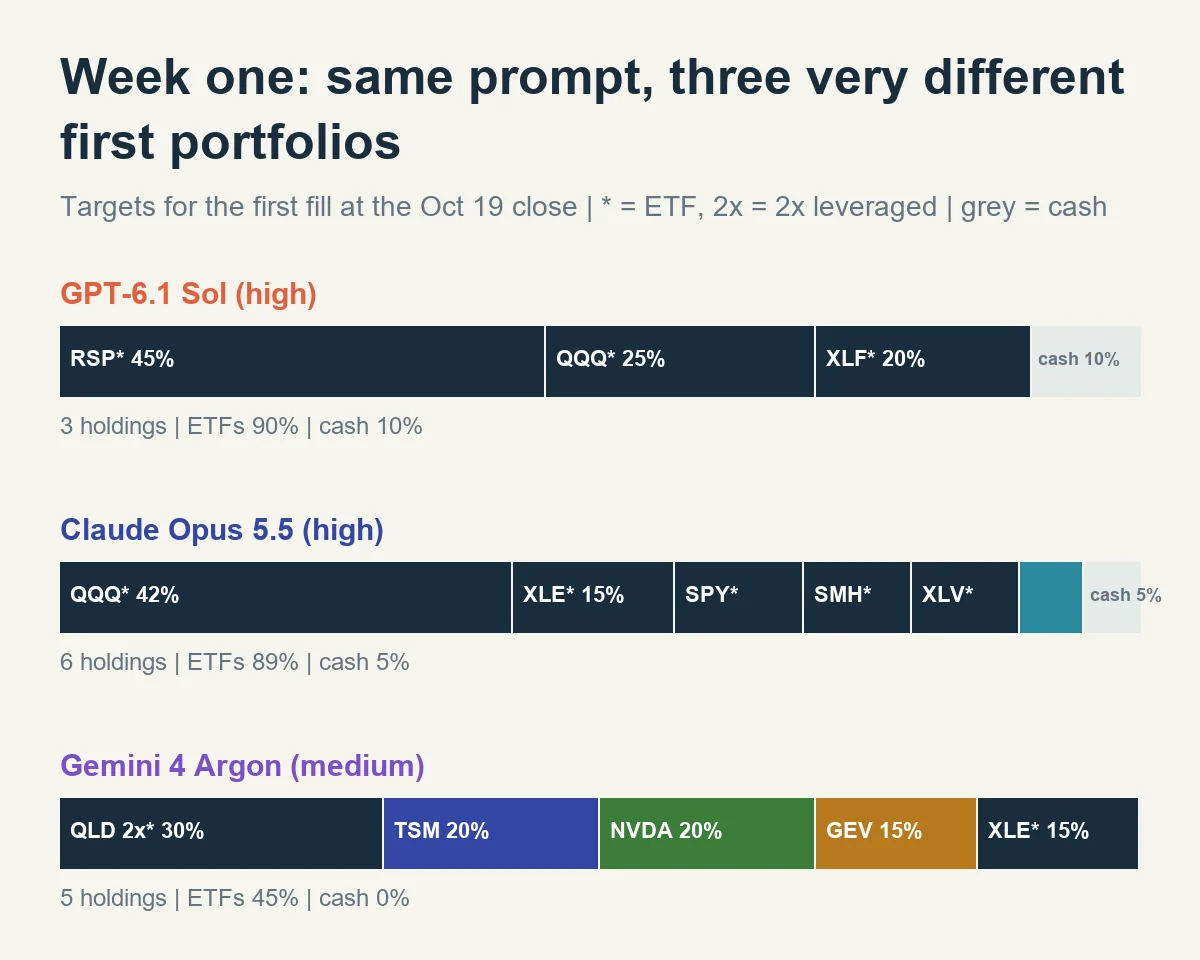
HSL 제작 — 10월 19일 종가 첫 체결 목표 비중, 별표는 ETF
- GPT-6.1 Sol: 3종목, 전부 ETF. 동일가중 S&P 500(RSP) 45%, QQQ 25%, 금융(XLF) 20%, 현금 10%. 기술주 약세 속에서 동일가중·금융이 앞선다는 쪽에 걸었고, 레버리지는 “검증된 우위가 생기기 전엔 안 쓴다”고 적었음
- Opus 5.5: 6종목, ETF 89%. QQQ 42%·SPY 12% 코어에, 지난주 11% 빠진 반도체(SMH·NVDA 16%)를 일부 저가 매수하고 에너지(XLE) 15%로 유가 쇼크 헤지, 헬스케어(XLV) 10%, 현금 5%
- Gemini 4 Argon: 5종목, 현금 0%. 나스닥100 2배 레버리지(QLD) 30%에 TSM·NVDA 20%씩, 전력 인프라 GE버노바(GEV) 15%, 에너지(XLE) 15%. 레버리지를 첫 주부터 쓴 건 Argon뿐임
- 같은 프롬프트인데 GPT는 지수 분산, Opus는 코어+위성+헤지, Argon은 레버리지까지 얹은 AI 반등 베팅으로 갈렸음
- 첫 가설도 성격이 드러남. GPT는 “RSP가 SPY보다 0.3%p 이상 앞서면 맞음”처럼 기준을 숫자로 촘촘하게, Opus는 “반도체가 QQQ보다 많이 오른다”처럼 결정의 근거를, Argon은 “QLD가 QQQ와 SPY를 둘 다 이긴다”처럼 공격적인 베팅을 걸었음
- 첫 성적은 10월 19일 종가 체결 뒤부터 프로젝트 페이지에 매일 올라옴