3줄 요약
- PPO에 호기심(RND)과 SimBa를 붙인 Mk.1로 낚시를 뚫었고, 그다음 기억 모듈을 붙이느라 며칠을 썼는데 실제 게임에선 효과가 없어서 전부 버렸음
- 구조를 비교하기 전에 볼 게 있었음. 섬 수를 8,192개에서 2,048개로 줄여 업데이트만 4배로 늘리니 같은 2,000만 스텝에서 8.3일이 22.5일이 됐음
- 최종 HyPPO는 40M 스텝, 씨드 3개에서 평균 26.9일, 30일 생존 79%임. 고유 아이디어로 넣은 앵커는 오히려 손해라 뺐고, HL-Gauss와 RND는 빼 보니 크게 나빠졌음
HyPPO의 30일째
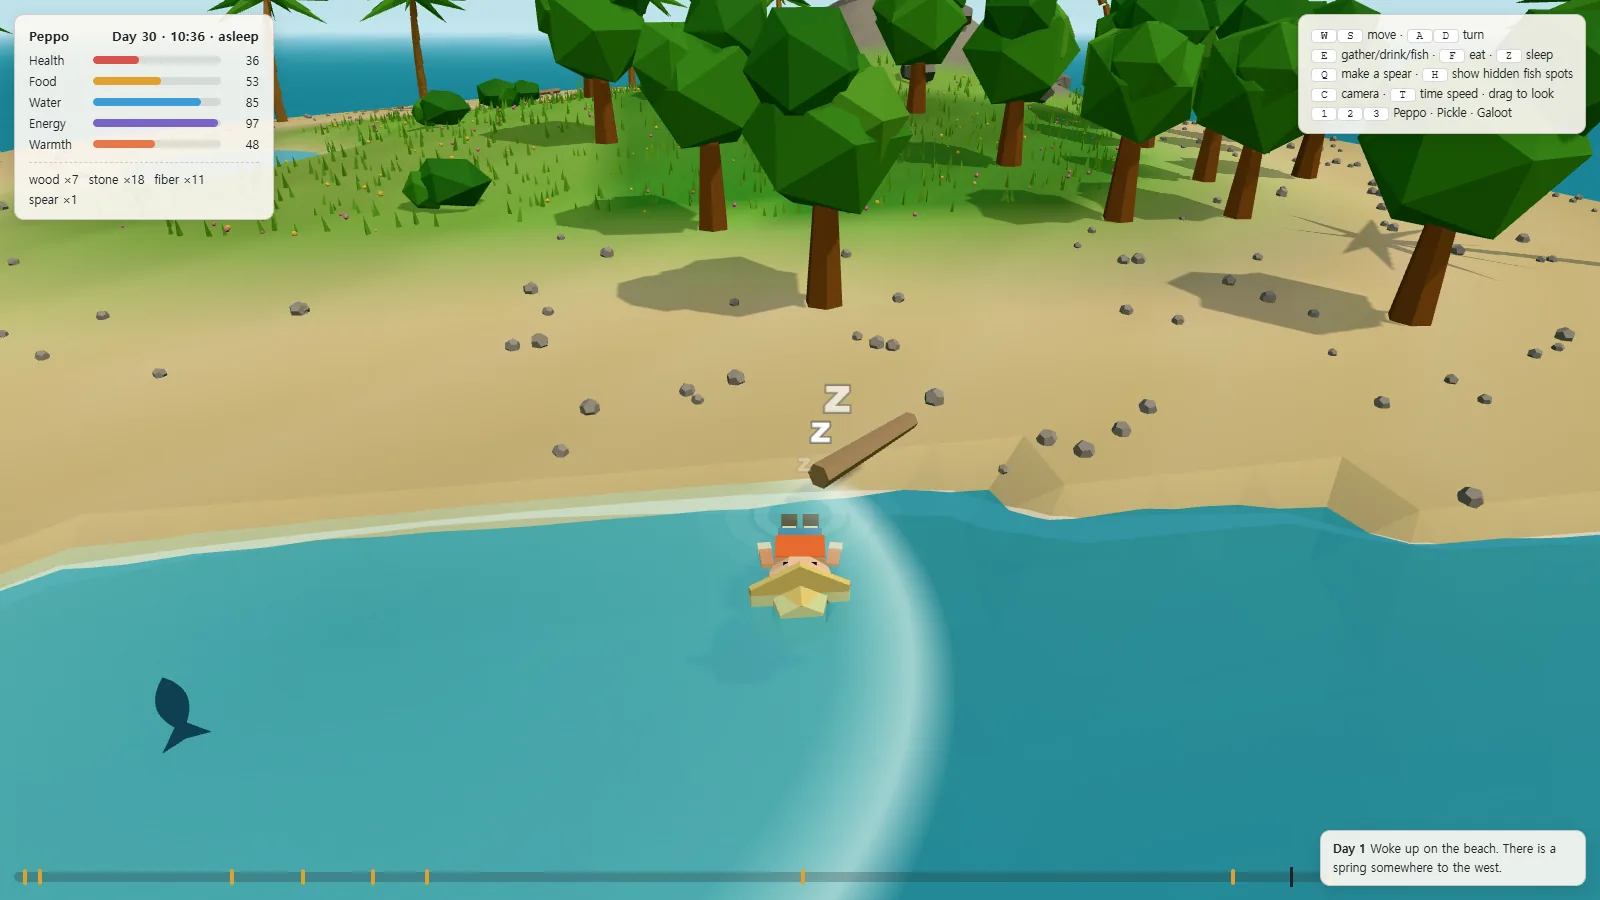
HSL 제작 — HyPPO 40M 스텝, 생존 보상만, 30일째. 11/1 규칙이라 물에서도 잠들 수 있었음 (2편에서 고침)
Mk.1: 호기심을 넣으니 낚시가 뚫림
- 3편의 계획대로 PPO + GRU에 SimBa 몸통, 호기심 RND, Simplicial Embedding(SEM)을 붙였음
- 뭐가 실제로 일하는지 보려고 하나씩 뺀 판도 같이 돌렸음
| 조건 | 평균 생존 | 30일 생존 | 생애당 물고기 |
|---|---|---|---|
| PPO + GRU | 10.9일 | 0% | 0.0 |
| Mk.1 | 21.6일 | 26.3% | 17.2 |
| Mk.1 − RND | 14.2일 | 0% | 0.2 |
| Mk.1 − SimBa | 14.7일 | 0% | 1.3 |
| Mk.1 − SEM | 21.6일 | 32.9% | 14.3 |
6,000만 스텝, 씨드 3개 평균, 섬 1,024개 평가, 10/30 (runs/p1/results.jsonl)
- RND나 SimBa를 빼면 물고기가 거의 안 잡혔음 (생애당 17.2마리 → 0.2, 1.3마리). Mk.1은 낚시해 본 판이 씨드별 75~94%였음
- SEM은 빼도 평균이 같았음. 필요하다는 증거가 없었음
- 부품 출처: SimBa · RND · Simplicial Embedding
기억을 붙이는 데 며칠을 썼음
- 다음 목표는 게임 전용이 아닌 범용 기억이었음. 같은 섬에서 여러 번 살면서 전생에 알아낸 걸 다음 생에 쓰게 하는 것
- 행동과 결과를 저장하는 fact 기억을 만들고, 두 번 사는 짧은 시험을 만들었음. 첫 번째 생에서 어느 음식이 특산물인지 알아내고, 두 번째 생에서 맞게 골라야 함
- 이 시험은 통과했음
| 2생 음식 선택 정확도 | 값 |
|---|---|
| fact 기억 | 0.977 |
| 기억 읽기를 0으로 지움 | 0.492 |
| 기억 내용을 일부러 뒤바꿈 | 뒤바뀐 기억을 0.978 따름 |
| 기억 없는 Mk.1 | 0.517 |
씨드 0, 시행 2,048개, 10/30 (runs/pr3/results.jsonl). 씨드 1·2의 fact 정확도는 0.985, 0.956
- 기억이 결정을 진짜로 바꾼다는 건 증명됨
- 그런데 실제 게임 5생에선 아무 효과가 없었음
| 5생 평가, 같은 규칙 | 평균 생존 | 1생 → 5생 |
|---|---|---|
| Mk.1 (기억 없음) | 8.95일 | |
| fact 기억 (보조 손실 있음) | 4.38일 | 4.41 → 4.30 |
| fact 기억 (보조 손실 없음) | 12.47일 | 12.69 → 12.39 |
| 위 모델에서 기억 읽기를 지움 | 12.40일 | 12.38 → 12.54 |
2,000만 스텝, 섬 8,192개로 학습, 씨드 1개, 섬 512개 평가, 10/31 (runs/dx_trial_*/eval.json)
- 지워도 그대로고, 살수록 나아지지도 않음. 실제 게임에선 정책이 기억을 안 썼음
- 나도 한 번 헛다리를 짚었음. 일반 게임 3일 정체를 붙들고 6,000만 스텝까지 돌렸는데 (fact 3.37일, 기억 없음 3.17일), 그건 시험용으로 바꾼 학습 설정 탓이었음. 예전 설정으로 돌리니 위 표처럼 나왔음
진짜 원인은 업데이트 횟수였음
- 섬을 많이 돌리면 스텝은 빨리 쌓이지만, 한 번 배우는 데 필요한 스텝도 같이 늘어남
- 섬 8,192개 × 롤아웃 64면 2,000만 스텝 동안 PPO 업데이트가 38번뿐임. 지금까지의 구조 비교는 전부 학습 초반을 보고 있었음. 그럼 새 부품은 늘 짐으로 보임
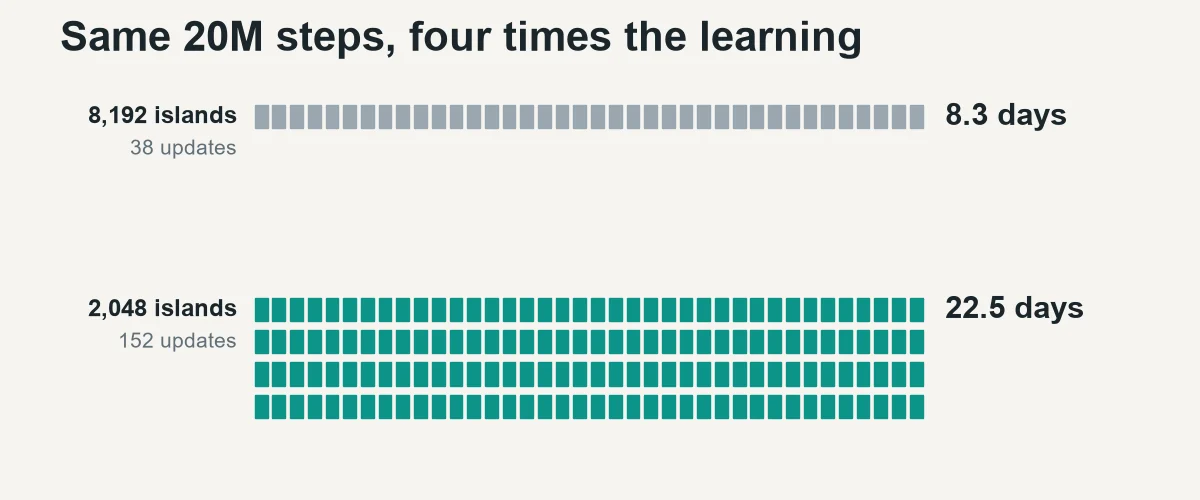
HSL 제작 — Mk.1, 2,000만 스텝, 섬 512개 평가, 씨드 1개, 10/31
| 동시에 도는 섬 | 업데이트 | 평균 생존 | 30일 생존 | 학습 시간 |
|---|---|---|---|---|
| 8,192 | 38번 | 8.3일 | 0% | 약 5분 |
| 2,048 | 152번 | 22.5일 | 34.0% | 9.9분 |
| 1,024 | 305번 | 19.8일 | 47.7% | 17.8분 |
runs/dx_plain_mk1, upd_e2048, upd_e1024 (eval.json, log.json). 8,192의 시간은 그 런의 속도(초당 약 6.6만 스텝)로 계산
- 2,048을 새 기본으로 잡고, 기억을 공정하게 다시 쟀음
- 공간 기억: 씨드 4개, 2,000만 스텝에서 GRU 18.5일, GRU + 공간 기억 19.2일, 읽기를 지우면 18.4일. 씨드 편차 안쪽임
- 낚시터가 매번 옮겨 가는 섬에서도, 4,000만 스텝 씨드 1개에서 GRU 25.5일, 공간 기억 20.1일이었음
- 그래서 기억 모듈은 전부 버리고 코어는 GRU로 남겼음
HyPPO: 구면 GRU만 남음
- 남은 문제는 씨드에 따라 낚시를 배우느냐 마느냐, 그리고 30M에서 배운 낚시를 40M에서 잃는 것이었음. Mk.1 씨드 0은 평균 27.2일에서 19.9일로, 생애당 물고기는 20.4마리에서 6.7마리로 무너졌음
- 구조를 네 AI(Fable·Astra·Argon·Opus)에게 자문받아 정리했고, 내가 건 조건은 “학습 요령이나 보상 설계 말고 구조일 것”이었음
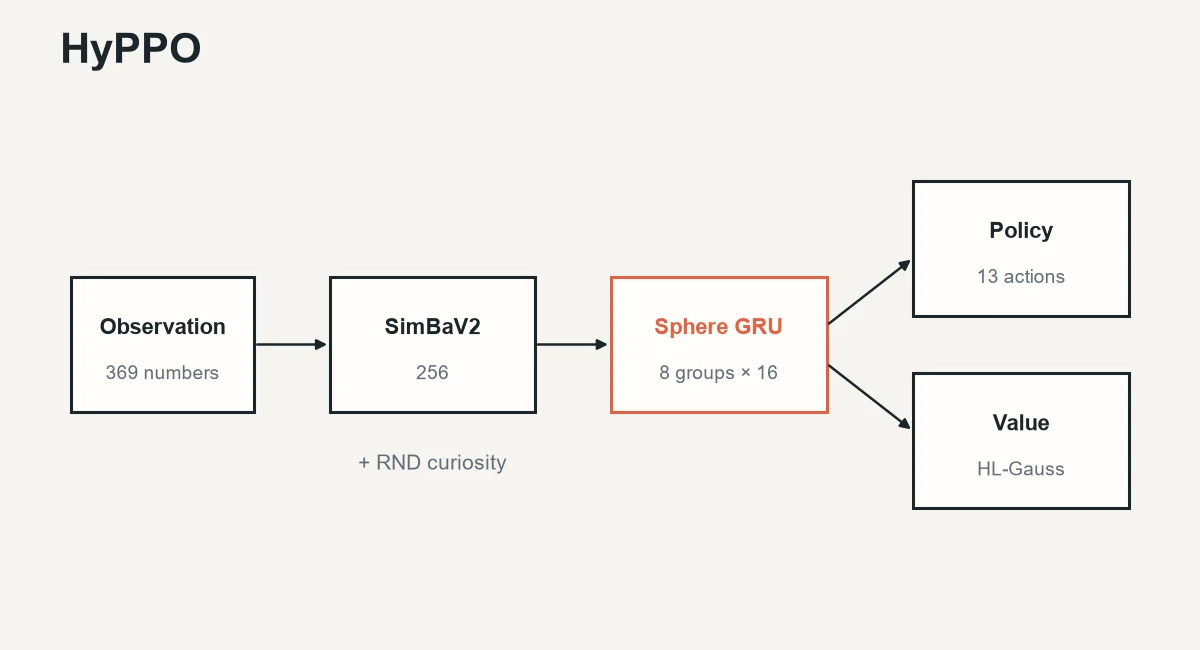
HSL 제작 — HyPPO 구조
- 몸통은 SimBaV2, 가치 머리는 HL-Gauss, 호기심은 RND임. 다 있는 부품임
- 직접 만든 건 코어인 그룹 구면 GRU임. 상태를 16차원 단위벡터 8개로 두고, GRU의 섞기를 구면 위에서 함
r, z = torch.sigmoid((gx[:, :2 * H] + self.u_rz(h)) * gs[:2 * H] + self.bias[:2 * H]).chunk(2, -1)
c = torch.tanh((gx[:, 2 * H:] + self.u_c(r * h)) * gs[2 * H:] + self.bias[2 * H:])
c = F.normalize(c.view(-1, G, D), dim=-1, eps=1e-3)
hv, zg = h.view(-1, G, D), z.view(-1, G, D)
hn = F.normalize(hv + zg * (c - hv), dim=-1, eps=1e-3)
train/nets.py SphereGRU.step 발췌 (앵커 부분 제외)
- 처음 핵심 아이디어는 그 위에 얹은 앵커였음. 그룹마다 학습되는 단위벡터 8개를 두고 상태를 그쪽으로 끌어당기면 낚시 습관이 안 지워질 거라는 Fable의 안이었음
- 40M 스텝까지 돌리고 위에서부터 하나씩 뺐더니 앵커만 손해였음
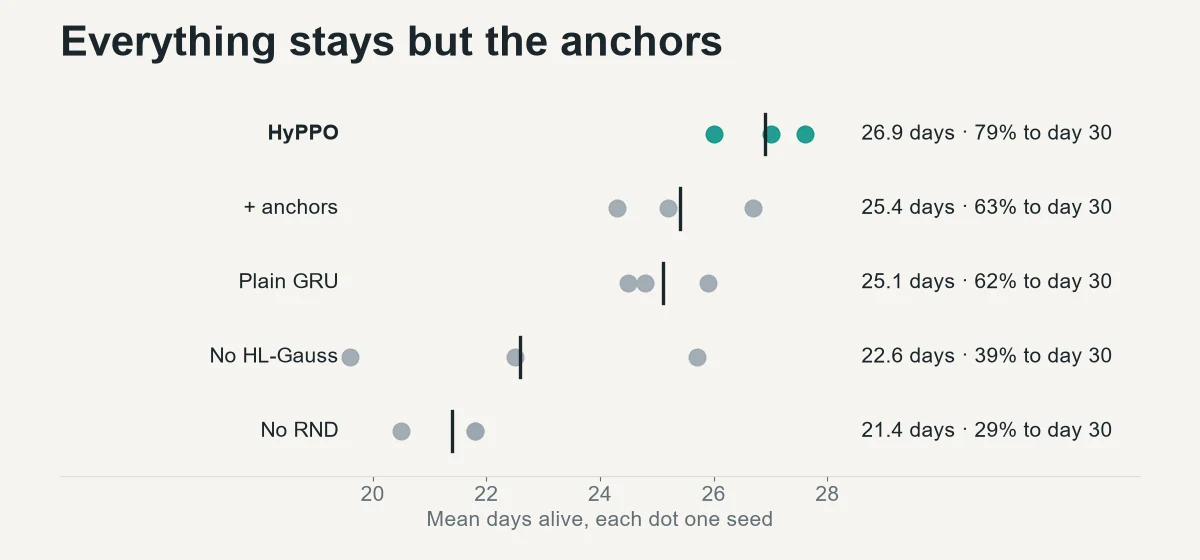
HSL 제작 — 4,000만 스텝, 씨드 3개, 섬 512개 평가, 11/1 (runs/mk2/summary.md). HL-Gauss·RND 제거는 앵커가 있는 조합에서 뺀 것
| 조건 | 평균 생존 | 30일 생존 | 생애당 물고기 | 초당 스텝 |
|---|---|---|---|---|
| HyPPO (앵커 없음) | 26.9 ± 0.8일 | 78.7% | 18.1 | 3.1만 |
| + 앵커 | 25.4 ± 1.2일 | 62.6% | 14.4 | 2.8만 |
| 일반 GRU | 25.1 ± 0.7일 | 61.5% | 14.1 | |
| HL-Gauss 제거 | 22.6 ± 3.0일 | 39.0% | 14.5 | |
| RND 제거 | 21.4 ± 0.8일 | 29.4% | 8.9 | |
| Mk.1 (같은 섬 수·스텝) | 23.0 ± 3.7일 | 44.9% | 13.7 |
runs/mk2/summary.md, runs/m2/summary.md. 초당 스텝은 씨드 0의 학습 로그
- 그래서 앵커를 뺀 조합을 최종으로 잡았고, 이름은 HyPPO(Hyperspherical PPO)로 정했음
- 한계도 분명함. 구면 GRU와 일반 GRU의 차이는 40M에선 1.8일이지만 20M에선 24.6일 대 24.7일로 없음. 씨드 3개에 섬 하나짜리 시험이라 논문급 주장을 할 근거는 아님
- PPO + GRU 기준선을 같은 섬 수·4,000만 스텝으로 돌려 비교하진 않았음
- 무너짐도 다 잡힌 건 아님. 씨드 3개 평균은 30M 26.1일에서 40M 26.9일로 유지됐지만, 나중에 Peppo를 학습할 땐 학습 로그 평균이 28.9일까지 갔다가 16.1일까지 내려간 뒤 24.4일로 끝났음
다시 한다면
- 구조를 비교하기 전에 업데이트 횟수부터 확인할 것. 여기서 며칠을 날렸음
- 시험 환경을 통과했다고 믿지 말 것. 기억은 짧은 시험에선 0.977이었는데 실제 게임에선 효과가 없었음
- 아이디어는 위에서부터 빼 보며 판정할 것. 공들인 앵커가 빠지는 데 40M 스텝 다섯 조건, 몇 시간이면 충분했음
- 다음 편은 이 두뇌로 살아가는 세 캐릭터 이야기임