3줄 요약
- 있는 알고리즘을 갖다 쓰기만 하면 재미없고, GPU도 한 장뿐이라 아주 효율적인 구조가 필요했음
- 가벼우면서 최근 성적이 좋은 RePPO·PQN·AGaLiTe를 골라 PPO 기준선과 같은 섬, 같은 15분으로 붙였더니 단순한 PPO가 평균 14.0일로 1등이었음
- 넷 다 낚시를 해 본 판이 최대 7.1%에 그쳤음. 그래서 PPO와 GRU를 바탕에 두고 낚시를 찾게 해 줄 우리 두뇌 Mk.1을 만들기로 했음
조건이 두 개였음
- 가벼울 것: RTX 3070 8GB 한 장에서 섬 4096개를 같이 돌려야 함. 학습 한 번에 며칠씩 걸리면 영상을 못 만듦
- 다양하게 행동할 것: 이건 클리어 대회가 아니라 보는 시뮬레이션임. 점수만 높고 매번 똑같이 움직이면 볼 게 없음
- 그리고 섬은 기억이 필요하다고 봤음. 샘이 어디 있었는지, 어느 덤불을 다 땄는지 기억해야 살아남을 테니까
탈락한 후보
- 월드 모델 계열 (DreamerV3 등): 세상을 상상으로 시뮬레이션하며 배우는 방식임. 데이터는 아끼지만, 우리는 GPU 시뮬레이터로 데이터가 남아돌고 모델이 무거워서 안 맞았음
- 트랜스포머 기억 (TrXL): 기억력은 좋은데 다른 후보보다 훨씬 무거움. 8GB에 섬 수천 개를 같이 올리기엔 부담이었음
고른 세 개와 기준선
| 이름 | 한 줄 설명 | 왜 골랐나 |
|---|---|---|
| PPO + GRU | 가장 널리 쓰는 정책 학습 + 순환 기억 | 비교 기준선 |
| RePPO | “여러 번 다시 해 볼 수 있다”고 보고, 최고 결과를 키우는 방향으로 배우는 PPO | 다시 할수록 과감해지는 탐험 |
| PQN | 리플레이 버퍼·타깃 네트워크 없이 병렬 환경으로 바로 배우는 Q러닝 | 단순하고 빠름 |
| AGaLiTe | 기억 크기가 고정된 가벼운 트랜스포머식 기억 | 트랜스포머 기억을 싸게 |
출처: RePPO 코드 · PQN 논문 · AGaLiTe 논문
- 넷 다 같은 섬, 같은 관찰, 같은 보상(살아 있는 하루당 1점)으로 15분씩 학습시켰음
- 학습률은 끝으로 갈수록 줄이고, 제일 잘한 순간의 뇌를 따로 저장함
시간으로 재면 PPO, 경험량으로 재면 AGaLiTe
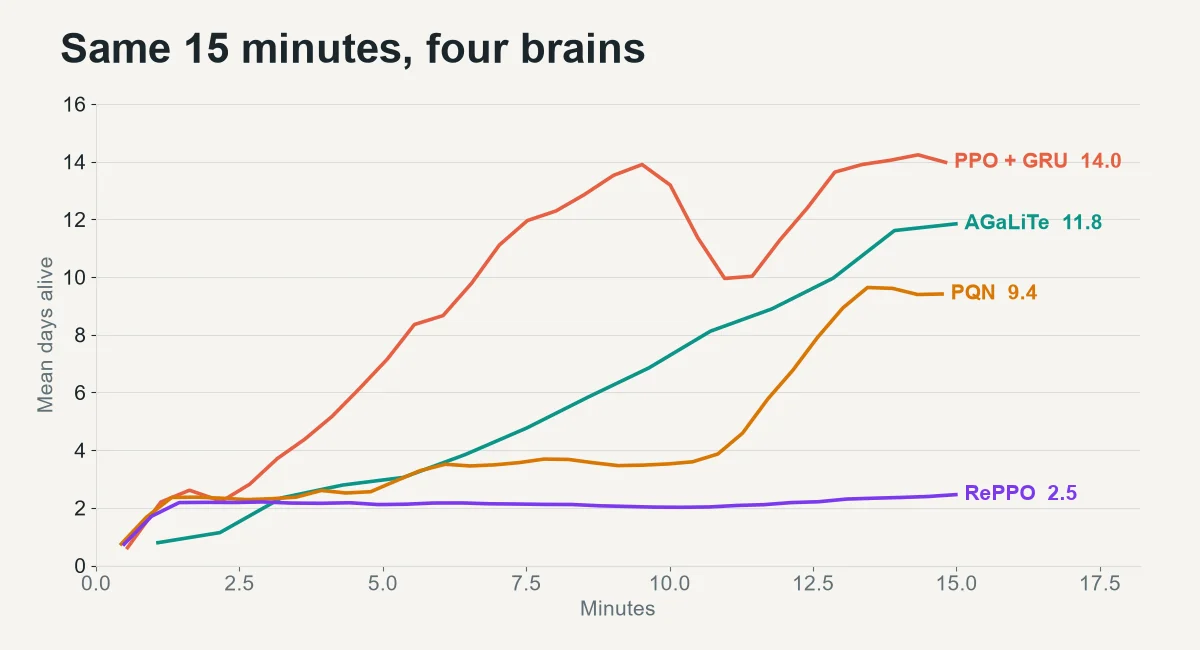
HSL 제작 — 섬 4,096개, 15분씩, 10/29 (runs/mk1_*/log.json)
| 알고리즘 | 15분 뒤 평균 생존 | 같은 1,835만 스텝에서 | 초당 스텝 | 낚시해 본 판 (최대) |
|---|---|---|---|---|
| PPO + GRU | 14.0일 | 11.1일 | 4.4만 | 7.1% |
| AGaLiTe | 11.8일 | 11.8일 | 2.0만 | 6.1% |
| PQN | 9.4일 | 3.5일 | 5.0만 | 3.5% |
| RePPO | 2.5일 | 2.1일 | 4.5만 | 0.3% |
학습 로그의 평균, 알고리즘마다 씨드 1개, 생존 보상만, 10/29
- 시간으로 재면 PPO가 1등임. 가장 단순한 기준선이 제일 잘했음
- 같은 경험량으로 재면 AGaLiTe가 조금 앞섬. 대신 한 스텝이 GRU보다 두 배 느림
- PQN은 제일 빠르게 돌고, 후반에 갑자기 치고 올라왔음
- RePPO는 15분 내내 2.5일 언저리에 머물고 95%가 목말라 죽었음. 원 코드 기본값을 그대로 썼는데, 우리 섬에 맞춘 튜닝 없이 나쁘다고 단정하긴 어려움
- 씨드가 하나씩이라 이 순위 자체는 믿을 게 못 됨. 큰 방향만 봤음
넷 다 낚시를 못 찾았음
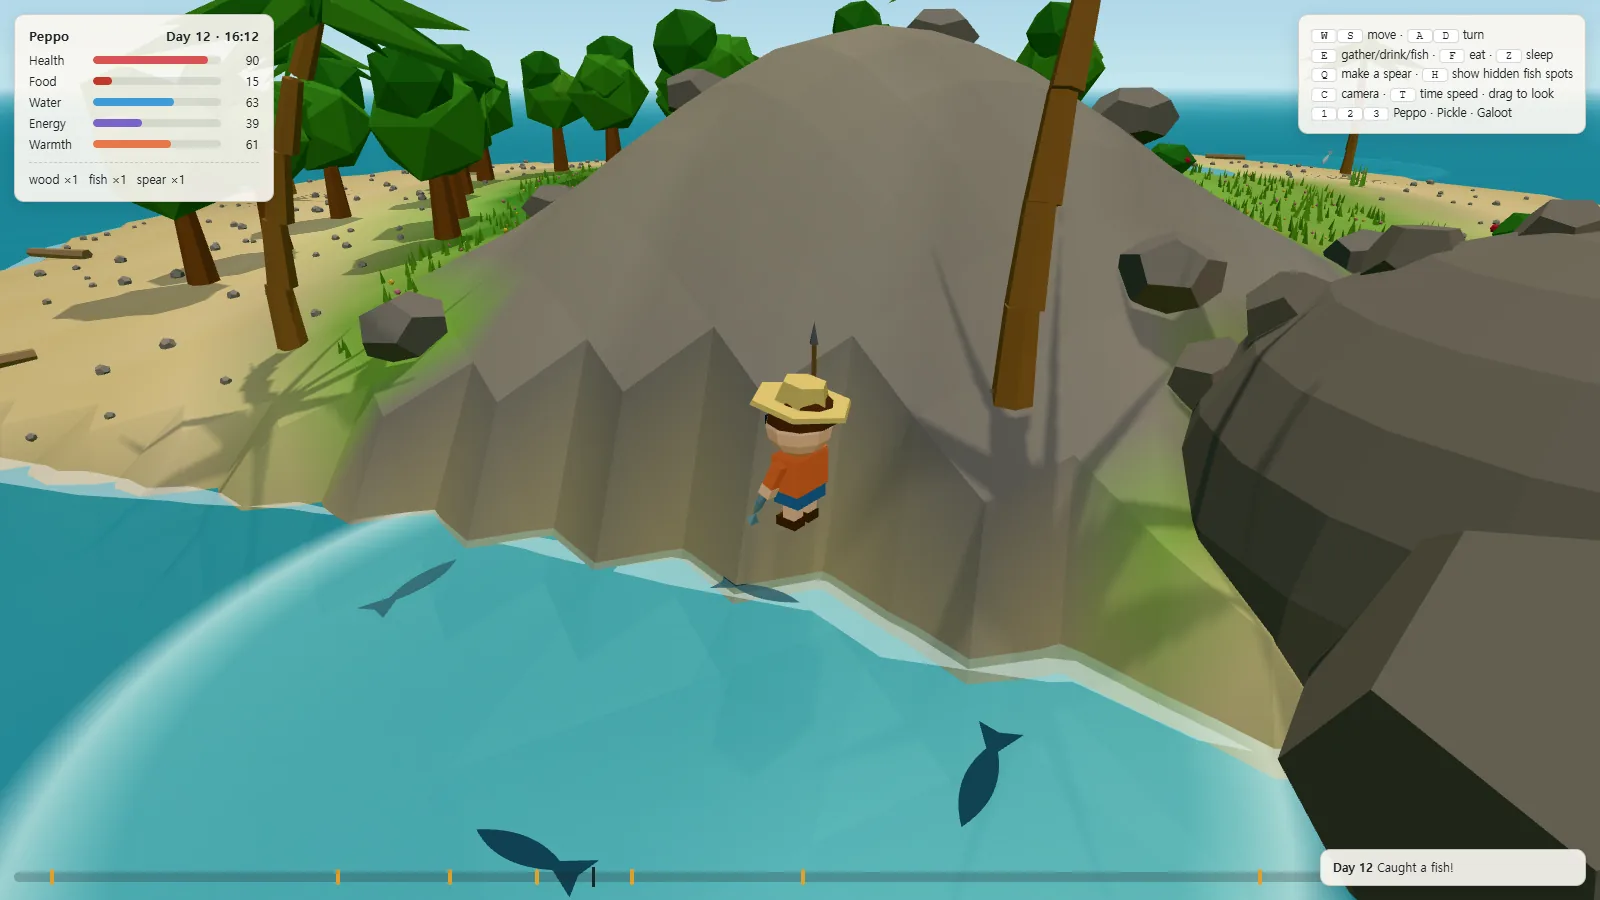
HSL 제작 — 이 편의 비교에는 없던 장면. 숨은 낚시터에서 물고기를 잡은 순간 (뒤에 만든 두뇌, 6,000번째 시도)
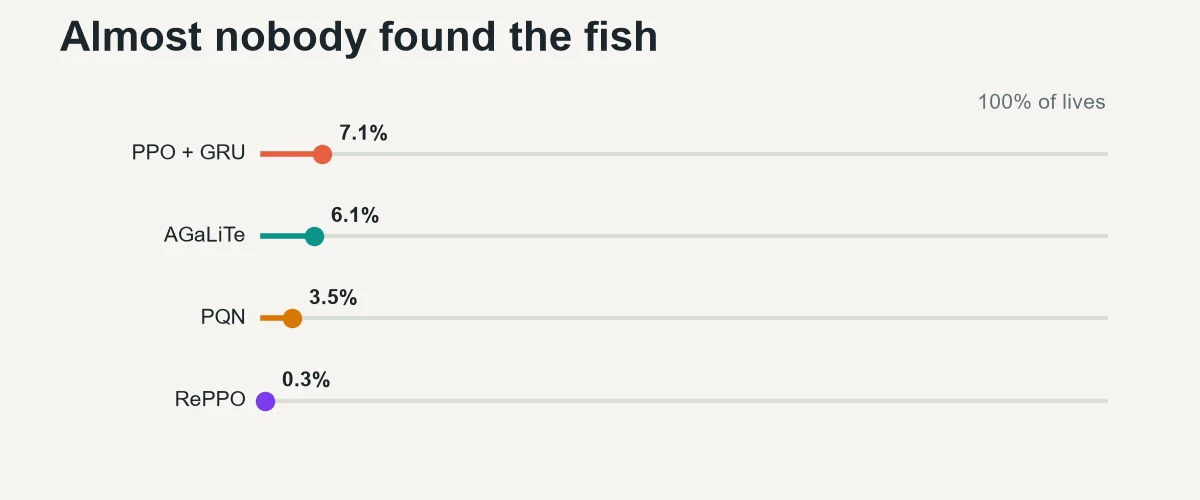
HSL 제작 — 낚시를 해 본 판의 최대 비율 (runs/mk1_*/log.json)
- 섬 식량은 보름 남짓이면 끝남 (2편). 물고기를 못 잡으면 보름 벽을 못 넘음
- 난이도를 낮췄는데도 낚시를 해 본 판은 최대 7.1%였음
- 그래서 이 대결의 진짜 결론은 순위가 아니라 “넷 다 같은 벽에 막힘”이었음
그래서 Mk.1은 이걸 노림
- 세 후보에서 실제로 가져온 건 거의 없었음. PPO + GRU가 제일 잘했으니 그대로 바탕에 둠
- AGaLiTe의 기억은 두 배 느린 값을 못 함. 기억은 일단 GRU로 감
- 대신 비교 밖에서 부품을 가져옴. 안 가 본 곳을 좋아하게 만드는 호기심(RND), 더 깊게 쌓아도 안정적인 몸통(SimBa), 정책 쪽 표현을 나누는 Simplicial Embedding
- 목표 1: 같은 GPU에서 지금보다 빨리 배울 것
- 목표 2: 섬 식량이 바닥나기 전에 낚시라는 돌파구를 찾을 것
- 목표 3: 매번 똑같이 움직이지 않고, 판마다 다른 생존 방식이 나올 것
다시 한다면
- 시간과 경험량, 두 기준으로 같이 잴 것. 어느 쪽으로 재느냐에 따라 1등이 바뀌었음
- 처음부터 씨드를 여러 개 돌릴 것. 씨드 하나로 매긴 순위는 나중에 다시 재야 했음 (4편)
- 평균 생존만 보지 말고 벽을 넘게 하는 행동(여기선 낚시)을 같이 잴 것. 이 숫자가 방향을 정해 줬음
- 다음 편은 Mk.1을 만들고 고쳐서 HyPPO가 되기까지임