3줄 요약
- Aurora 본체는 얼려 두고, 관측소마다 Aurora 예보를 고치는 예측 헤드(head)를 LightGBM과 신경망 12종으로 만들어 봤음
- 최종은 LightGBM과 CNN 헤드 두 개를 섞은 앙상블이고, 테스트 기간엔 기온·습도·풍속·비 네 지표 모두 기상청보다 좋았음
- 단, 2026년 7월~10월 12일 발표 33번, 2일 예보, ASOS 97곳 기준임. 서울 비는 졌음
헤드가 하는 일
- 입력은 관측소 위치로 뽑은 Aurora 값 40여 개임 (기온, 이슬점, 바람, 구름, 강수, 상층 기온 등)
- 여기에 발표 직전까지의 실제 관측을 붙임: 지금 기온·습도·바람, 최근 6·24시간 강수, 어제 같은 시각 값
- 제일 효자는 “방금까지 Aurora가 얼마나 틀렸나”였음. 발표 전 1~6시간의 관측 빼기 Aurora
- 출력은 Aurora 값에 더할 보정량(기온·습도·풍속)과 1mm 이상 비 확률임
- Aurora는 얼려 둔 채라 GPU는 박스 만들 때만 쓰고, 헤드 학습은 가벼움
신경망 사다리
한 칸씩 기능을 붙여 가며 검증 기간 점수를 쟀음 (시드 두 개 평균)
| 단계 | 기온 MAE | 습도 MAE | 풍속 MAE | 비 F1 |
|---|---|---|---|---|
| 기상청 | 1.192 | 8.82 | 1.055 | 0.358 |
| Aurora 제로샷 | 1.460 | 8.66 | 1.198 | 0.587 |
| LightGBM | 0.969 | 6.63 | 0.620 | 0.608 |
| MLP | 1.014 | 6.81 | 0.676 | 0.609 |
| + TabM (작은 앙상블 8개) | 1.012 | 6.80 | 0.673 | 0.605 |
| + 리드 시간 축 어텐션 | 1.040 | 6.93 | 0.692 | 0.598 |
| + 관측소 축 어텐션 | 1.028 | 6.91 | 0.683 | 0.598 |
| + 최근 24시간 관측 토큰 | 1.025 | 6.92 | 0.682 | 0.607 |
| + Aurora 격자를 CNN으로 읽기 | 0.999 | 6.78 | 0.675 | 0.602 |
| + 격자를 Perceiver로 읽기 | 0.995 | 6.77 | 0.670 | 0.604 |
- 사다리 맨 위까지 올라가도 LightGBM 혼자를 못 이겼음
- 학습 발표가 122번뿐이라 표 데이터에선 나무 모델이 원래 셈
- 대신 신경망은 Aurora 격자를 직접 읽어서 LightGBM과 틀리는 방식이 달랐음
- 섞어 보니 바로 좋아졌음: LightGBM 2 : CNN 헤드(시드 2개) 1 : 1
- 검증 기간 앙상블은 기온 0.953℃, 습도 6.51%, 풍속 0.632m/s, 비 F1 0.624였음
- 2~3개 조합을 전부 돌려 봐도 차이는 0.003 이내라 제일 단순한 이 조합으로 정했음
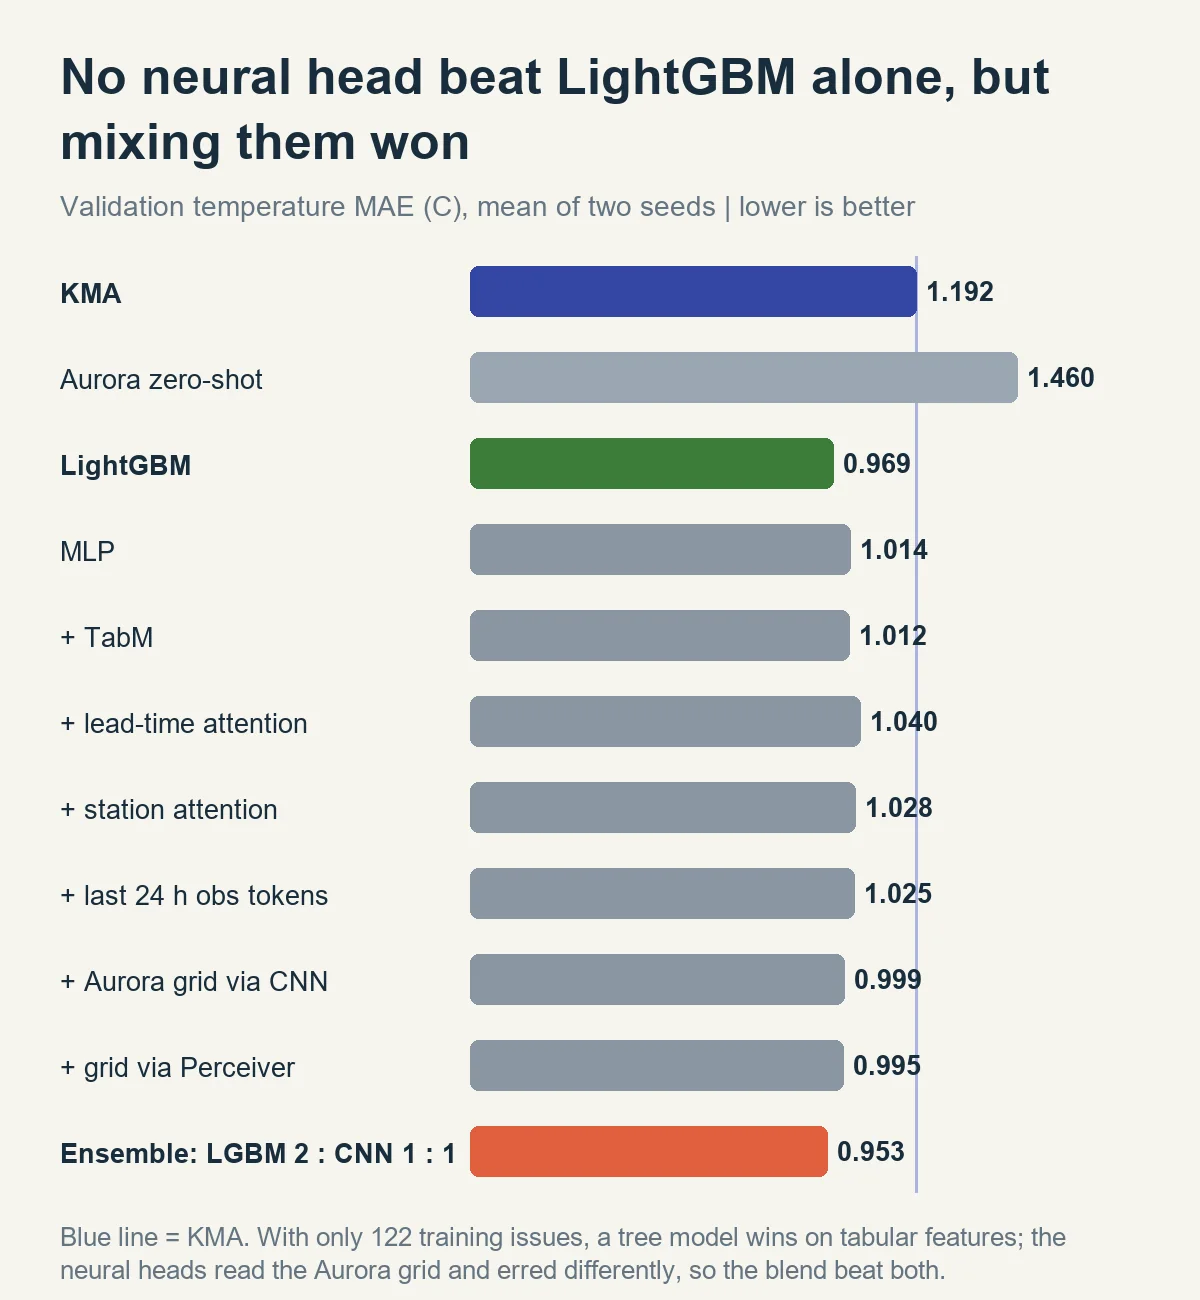
HSL 제작 — 검증 기간 기온 MAE, 시드 두 개 평균
테스트는 딱 한 번만 열었음
테스트 기간(2026-07~10-12) 발표 33번 × 97곳 × 48시간. 모델과 비 기준은 검증 기간에서 다 정해 두고 한 번만 채점했음
| 기온 MAE | 습도 MAE | 풍속 MAE | 비 F1 | |
|---|---|---|---|---|
| 기상청 | 1.077℃ | 6.51% | 0.963m/s | 0.264 |
| Aurora 제로샷 | 1.307℃ | 6.87% | 1.231m/s | 0.412 |
| 우리 앙상블 | 0.836℃ | 4.54% | 0.577m/s | 0.409 |
- 기온 오차는 기상청보다 22% 작았고, 습도는 30%, 풍속은 40% 작았음
- 비 F1도 0.41로 기상청 0.26보다 높았음
- 다만 비는 앙상블이 Aurora 제로샷과 거의 같았음. 헤드가 비를 크게 더 잘 맞히진 못했다는 뜻임
- 대구는 비 F1 0.54 대 0.19로 크게 이겼음
- 서울은 기온·습도·풍속은 이겼지만 비는 0.19 대 0.22로 졌음 (테스트 기간 서울에 비 온 시간이 38시간뿐이라 흔들리는 숫자이긴 함)
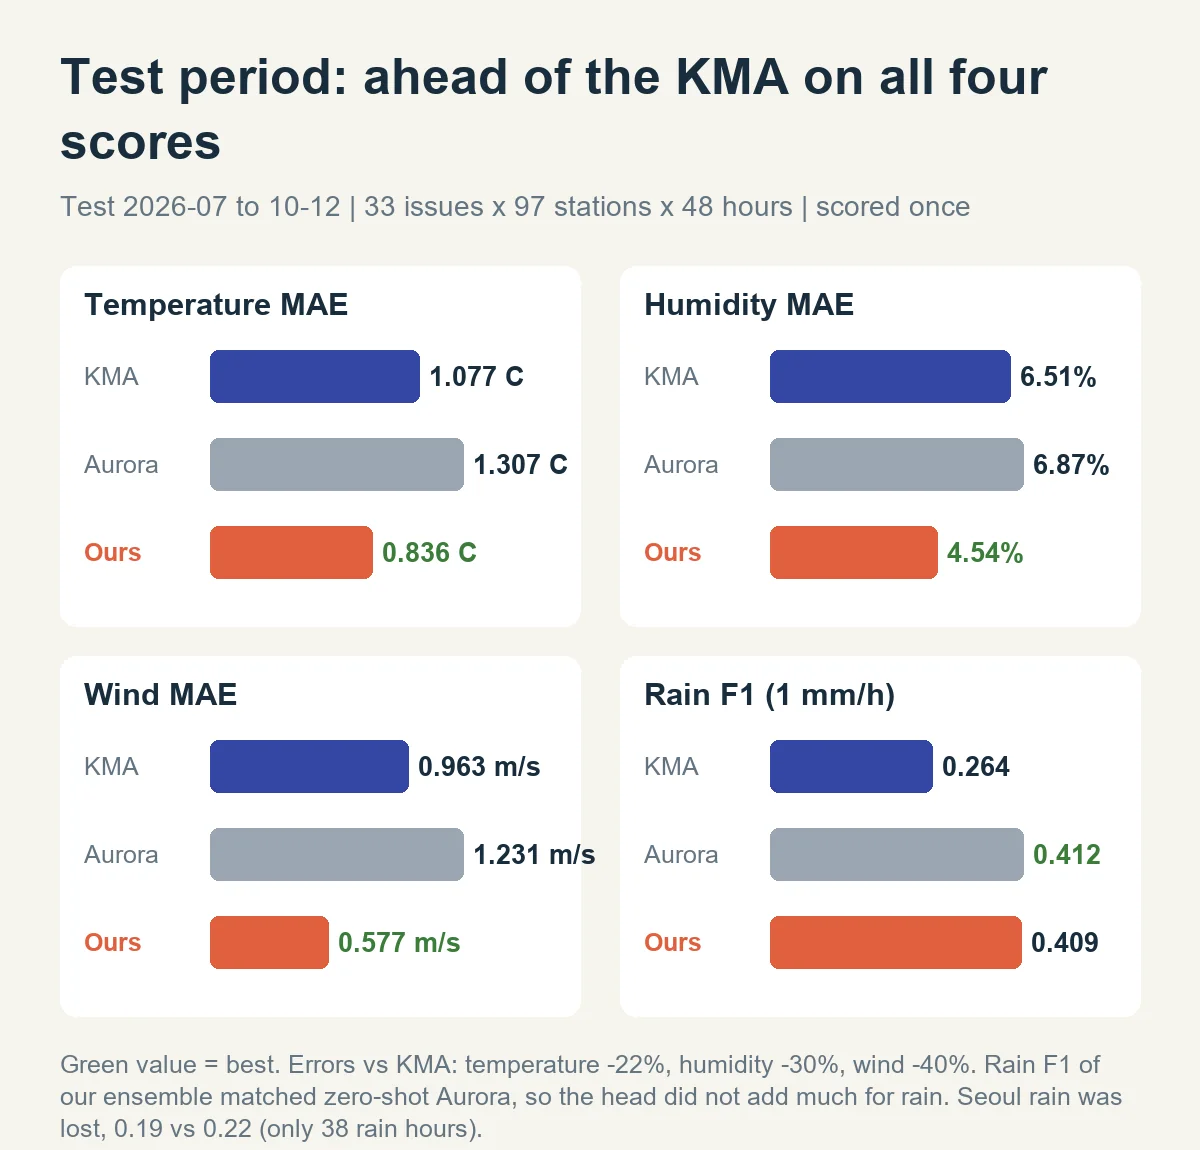
HSL 제작 — 테스트 기간 33회 발표 × 97개 관측소 × 48시간, 한 번만 채점
오해 없게 적어 둠
- 이긴 건 이 테스트 기간, 이 97개 관측소, 발표 후 48시간까지임
- 사계절 전부나 태풍·폭설 같은 큰 사건에서 이긴다는 근거는 아직 없음
- 기상청 예보는 5km 격자 값을 그대로 관측소에 대 본 것이라, 예보관이 실제로 전하는 지역 예보 문장과는 다름
- 그리고 이게 좀 불공평한 부분임. 기상청 단기예보는 관측소가 아니라 5km 칸 하나의 값이고, 우리 헤드는 관측소 관측으로 학습했으니 지점 맞춤 보정을 공짜로 받은 셈
- 그래서 기상청한테도 같은 혜택을 줘 봤음. 검증 기간에서 기상청의 관측소별(+시각별) 평균 오차를 구해 테스트 예보에서 빼 줌
| 테스트 MAE | 우리 앙상블 | 기상청 그대로 | 기상청 + 관측소 보정 | 기상청 + 관측소·시각 보정 |
|---|---|---|---|---|
| 기온 | 0.836℃ | 1.077℃ | 1.033℃ | 1.019℃ |
| 습도 | 4.54% | 6.51% | 6.33% | 6.17% |
| 풍속 | 0.577m/s | 0.963m/s | 0.887m/s | 0.877m/s |
- 기온 차이는 0.24℃에서 0.18℃로 줄었음. 격차의 4분의 1쯤은 격자 대 지점 차이였다는 뜻
- 그래도 순위는 안 뒤집혔음. 보정해 준 기상청보다도 기온 18%, 습도 27%, 풍속 34% 작았음
- 기상청 격자가 특히 안 맞던 곳은 양산(−1.3℃), 북창원(−1.2℃), 인제(−1.1℃) 같은 산골·분지였음
- 비는 아직 갈 길이 멂. 1시간만 어긋나도 틀린 걸로 치는 채점이라 시각 맞히기가 제일 어려웠음
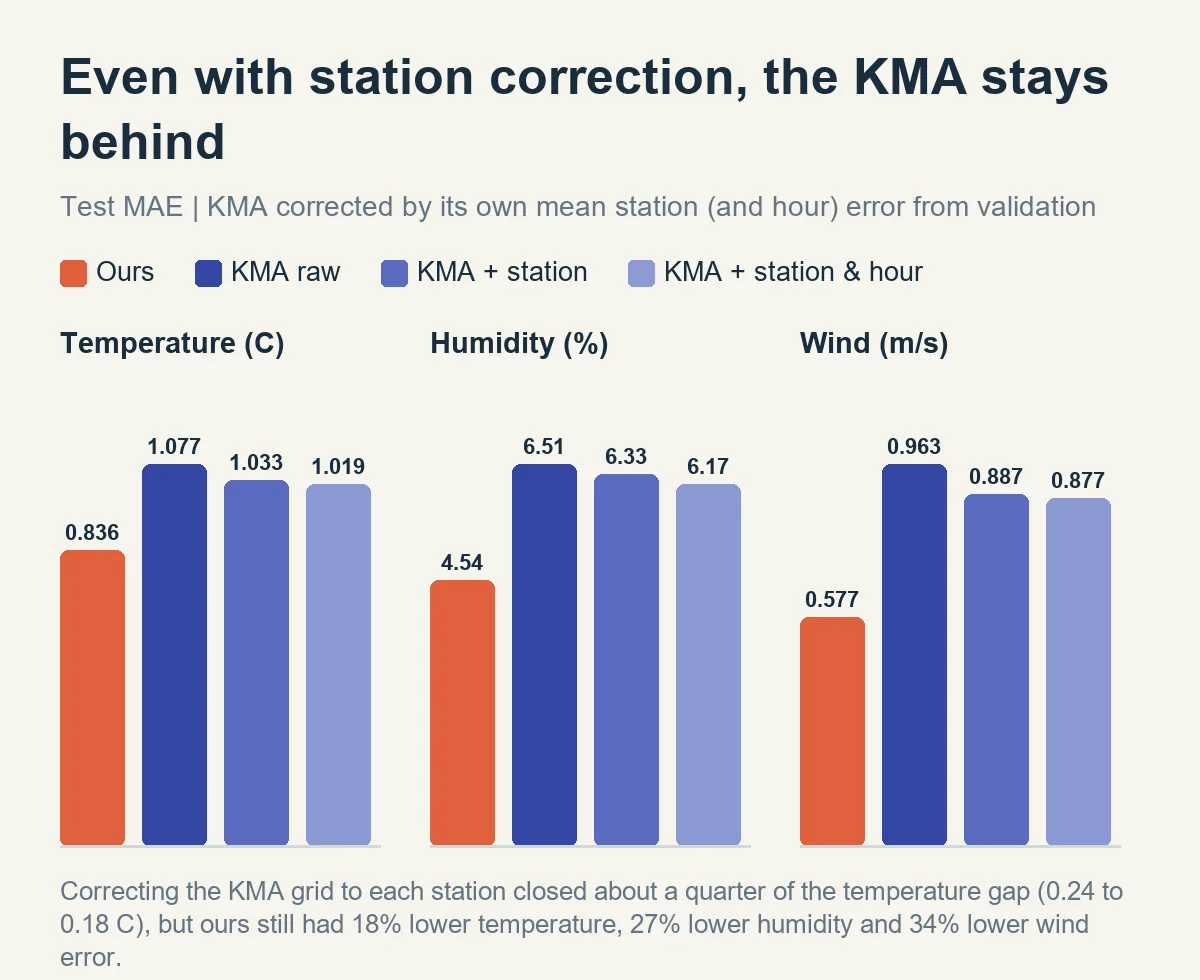
HSL 제작 — 기상청에 검증 기간 평균 오차 보정을 해 준 뒤 다시 비교
하루 종일 일한 L4 후기
- Aurora 박스 195개, 신경망 사다리, 앙상블까지 전부 Colab Pro의 L4 한 장으로 했음
- 박스는 밤새 만들고, 낮엔 사다리를 모델당 20~30분씩 줄줄이 돌렸음
- 그 사이 사람이 한 일은 주로 “아직 돌아가?” 확인이었음
- 비싼 GPU 없이도 사전학습 모델 + 작은 헤드 + 앙상블이면 개인도 기상청이랑 붙어 볼 만하다는 게 제일 큰 수확임
GPU가 더 있으면
- 지금은 L4 24GB에 맞추느라 Aurora 본체를 얼려 두고 헤드만 학습했음
- GPU가 더 있으면 같은 틀에서 Aurora 본체까지 한국 관측에 맞게 추가 학습하거나 사전학습부터 다시 할 수 있음
- 10일 예보도 같은 틀임. 박스를 240시간까지 굴리고 헤드를 리드 240시간까지 학습하면 됨
- 바뀌는 건 GPU 시간뿐이라 코드는 거의 그대로 씀
앞으로
- 이 서비스는 당분간 매일 05시 발표 기준 2일치 예보로 운영할 예정임
- 우리 예보와 기상청 예보를 나란히 띄우고, 지난 7일 성적도 관측과 맞춰 공개함 (프로젝트 페이지)
- 그리고 예고 하나: 곧 미국판도 낼 예정임. 상대는 미국 기상청(NWS)임
- 재밌었음. 끝
- 앞으로도 이런 프로젝트 계속할 거니 재밌게 봐 주셈