3줄 요약
- 기상청 쇼츠 나레이션을 직접 녹음하는 대신 1편의 TTS로 만들었음. 줄마다 세 번씩 만들고 기계가 받아 적어 제일 나은 걸 골랐음
- Qwen3-TTS와 OmniVoice를 블라인드로 들어 보고 OmniVoice로 정했고, 속도는 생성할 때 말고 섞을 때 1.5배로 올렸음
- 내 목소리 10문장으로 LoRA 학습도 해 봤는데, 유사도는 대부분 참고 녹음을 바꾼 데서 올랐음 (0.72 → 0.81, LoRA로 0.82)
쇼츠 한 편을 줄 단위로 만듦
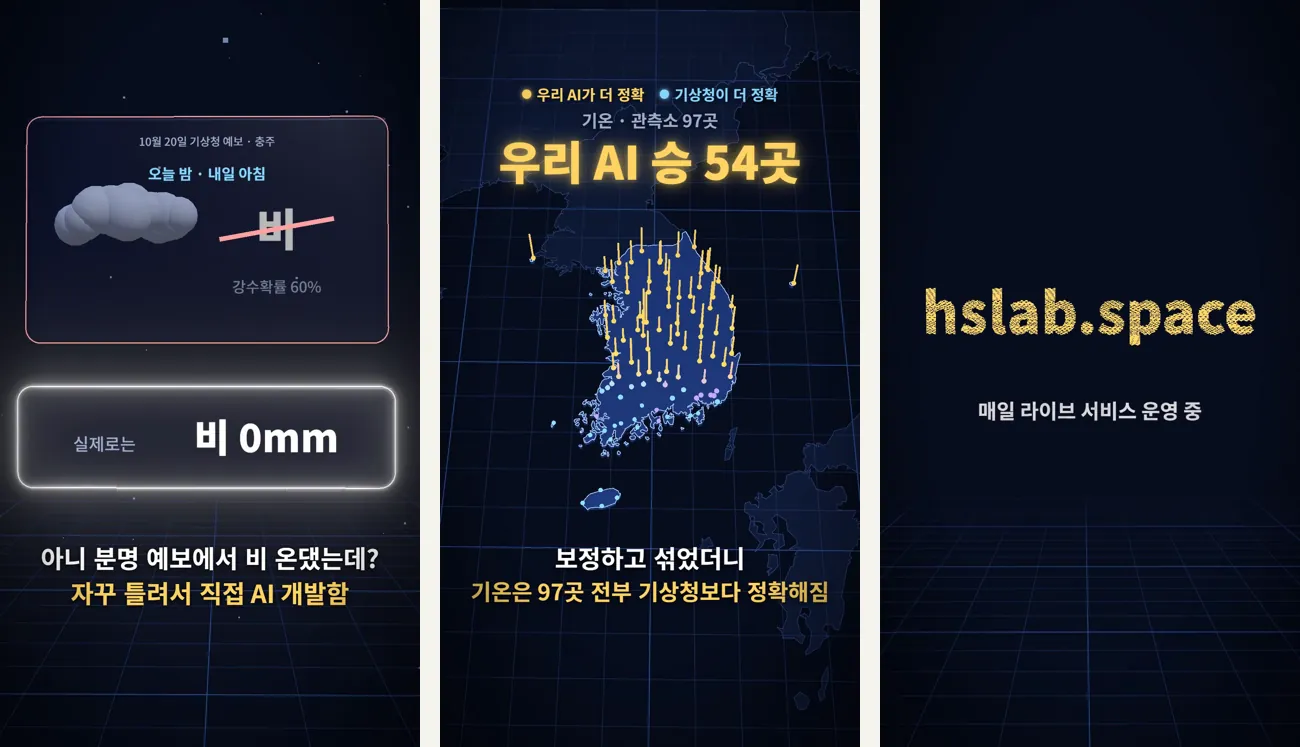
HSL 제작 — 이 목소리로 나레이션을 넣은 기상청 쇼츠의 장면들
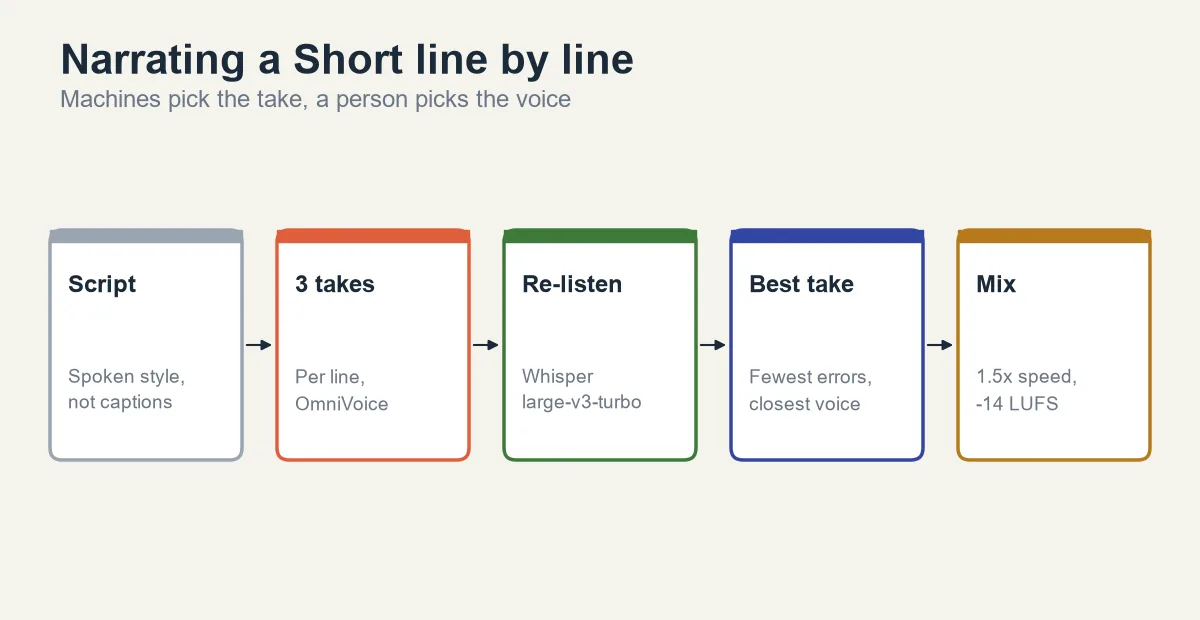
HSL 제작 — 나레이션 한 줄이 영상에 들어가기까지
- 대본은 자막과 따로 씀. 자막은 음슴체지만 소리로는 어색해서, 설명은 해요체, 결과는 습니다체로 섞었음
- 줄마다 테이크를 세 개씩 만들고, Whisper가 다시 받아 적은 글자와 대본을 비교해 오류가 가장 적은 걸 고름
- 오류가 같으면 내 목소리와 더 닮은 테이크를 고름
- 처음 받아쓰기는 Whisper medium이었는데, “~했음”을 자꾸 “~했습니다”로 적어서 멀쩡한 테이크를 틀렸다고 했음. large-v3-turbo로 바꾸고 나서야 점수가 믿을 만해짐
- 최종본은 고른 테이크의 발음 오류가 모두 0%였음
Qwen3-TTS와 블라인드로 붙임
| 같은 대본 18줄, 줄마다 3테이크 | Qwen3-TTS 1.7B | OmniVoice |
|---|---|---|
| 고른 테이크 발음 오류 | 0.0% | 0.0% |
| 고른 테이크 목소리 유사도 | 0.713 | 0.733 |
| GPU 메모리 | 4.23GB | 2.10GB |
| 생성 시간 | 5.5초 음성에 16.4초 | 5.0초 음성에 2.2초 (1편) |
- 둘 다 Apache 2.0이라 유튜브에 써도 됨
- 숫자만 보면 큰 차이는 없었음. 그래서 어느 쪽인지 숨기고 A, B로 들어 봤고, A(OmniVoice)가 더 자연스럽다고 골랐음
- Qwen3-TTS는 서비스를 켜 둔 채로도 돌아갔지만 느렸음. 한 줄 만드는 데 실제 길이의 세 배쯤 걸렸음
속도는 섞을 때 올림
- 쇼츠라 기본 속도는 너무 느렸음. OmniVoice의 속도 옵션을 1.5로 주니 말끝이 잘렸음
- 그래서 1배속으로 만들고, 영상에 섞을 때 속도만 올리는 방식으로 바꿈. 이러면 말끝은 그대로 남음
- 2배속, 1.7배속을 들어 본 뒤 1.5배속으로 확정함
- 2배속에서 뭉개지는 테이크가 있어서, 테이크 고르기도 2배속 버전을 받아 적어서 판단했음
- 앞뒤 무음 자르기도 함정이었음. 끝부분을 −45dB 기준으로 자르니 말끝이 같이 날아가서, 앞쪽만 자르기로 함
- 음량은 유튜브 기준에 맞춰 −14 LUFS로 두 번 측정해 맞춤
녹음을 바꾸니 목소리가 닮아짐
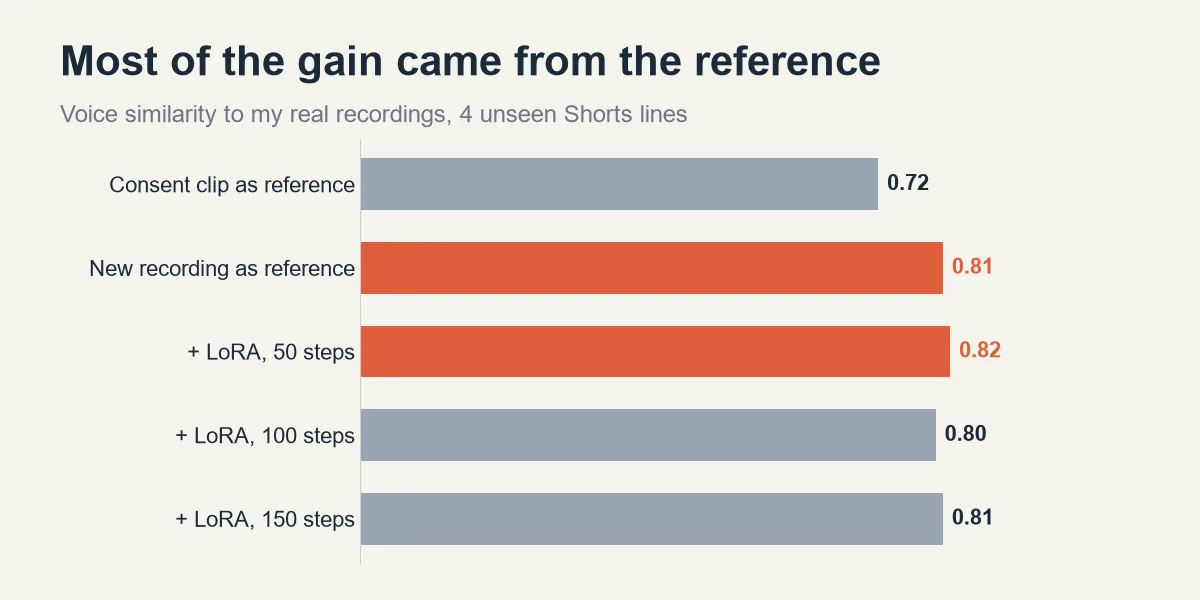
HSL 제작 — 학습에 안 쓴 쇼츠 문장 4개, 10/25 측정
- 처음 나레이션의 참고 목소리는 사이트에서 녹음한 동의 문장 한 줄이었음
- 목소리를 더 닮게 하려고, 상황별 범용 문장 10개(81초)를 새로 녹음함. 영상 대본이 아니라 다음 영상에도 쓸 수 있는 문장들임
- 그 10문장으로 OmniVoice에 LoRA를 학습했음. 3070에서 150스텝, 3분이면 끝남
- 비교는 학습에 안 쓴 쇼츠 문장 4개로 했음. 참고 녹음만 새 녹음으로 바꿔도 0.72에서 0.81로 올랐고, LoRA 50스텝은 0.82였음
- 100스텝, 150스텝은 오히려 0.80, 0.81로 조금 내려감. 10문장으로는 오래 학습할수록 나아지지 않았음
- 블라인드로 들어 보고 고른 것도 LoRA 50스텝이라, 나레이션을 그걸로 바꿈
batch_tokens 2048 -> 2.4초/스텝
batch_tokens 4096 -> 메모리 넘침, 10초/스텝
webdataset이 C:\ 경로를 URL로 읽음 -> 상대 경로로 바꿔 해결- 학습하는 동안은 GPU를 비워야 해서 서비스 서버를 잠깐 꺼 뒀음
다시 한다면
- 참고 녹음부터 제대로 할 것. 조용한 곳에서 여러 문장을 녹음한 게 LoRA보다 효과가 컸음
- 받아쓰기 모델은 대본 말투로 먼저 시험해 볼 것. 음슴체를 습니다체로 바꿔 적는 모델이면 점수가 다 틀림
- 속도는 모델 옵션보다 섞는 단계에서 바꿀 것. 말끝이 안 잘림
- LoRA는 녹음을 수십 문장으로 늘리고 다시 해 볼 생각임. 10문장에선 50스텝 이후로 나아지지 않았음
- 체험은 프로젝트 페이지에서 할 수 있음. 서비스는 아직 학습 안 한 기본 OmniVoice로 돌아감