3줄 요약
- 정해진 한 문장만 읽으면 아무 문장이나 내 목소리로 읽어 주는 서비스를 집 RTX 3070 한 장으로 만들기로 함
- 수익화에 문제없는 오픈소스 다섯 개를 같은 문장으로 돌려 봤고, 목소리 유사도 0.812에 5초 음성을 2.2초에 만드는 OmniVoice를 골랐음
- 방문자 목소리는 사이트 서버와 터널을 거쳐 집 PC까지 오고, 동의 문장을 실제로 읽었는지 Whisper가 먼저 확인함
라이선스부터 걸렀음
- 사이트에 광고가 붙고 유튜브 영상에도 쓸 거라, 비상업(NC) 라이선스 모델은 처음부터 뺐음
- 그래서 Fish Audio S2, XTTS-v2, F5-TTS는 후보에서 빠짐
- 처음엔 Chatterbox, CosyVoice3, GPT-SoVITS 셋으로 시작했음. 다 MIT나 Apache 2.0이었음
- 그런데 최신 논문 비교표를 찾아보니 셋 다 최상위가 아니었음. 한국어 목소리 유사도는 VoxCPM2와 OmniVoice가 0.83 안팎으로 공개 모델 중 가장 높았음 (OmniVoice 논문, 다국어 비교표)
- 그래서 둘을 더해 다섯 개를 직접 붙여 보기로 함
같은 목소리, 같은 문장으로 다섯 개를 붙임
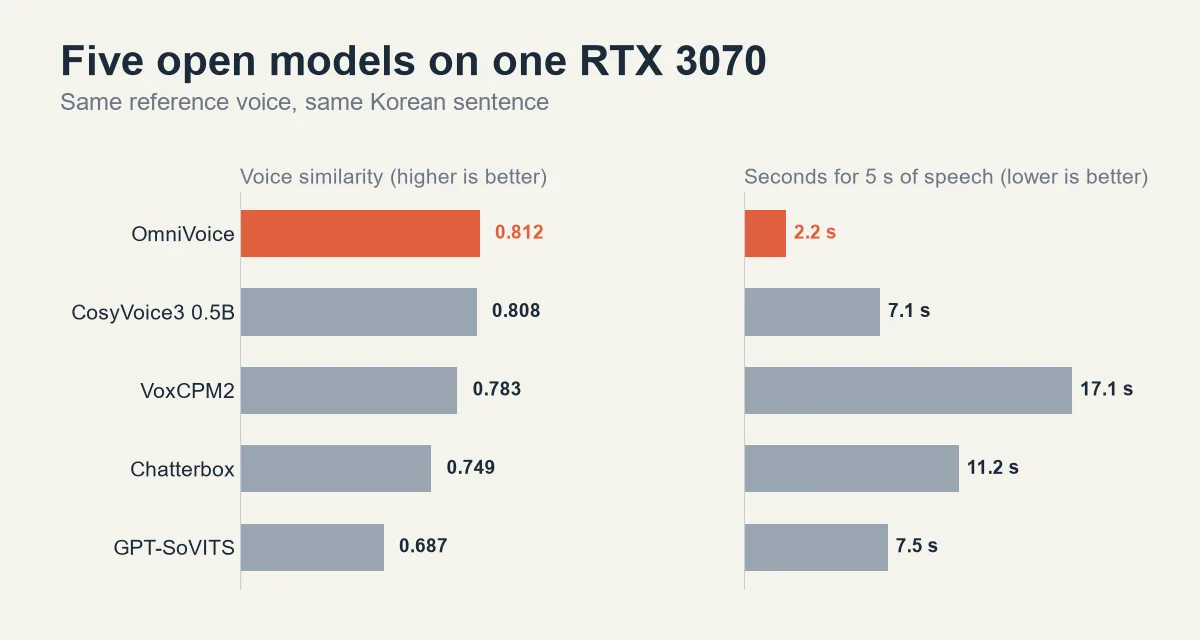
HSL 제작 — RTX 3070, 참고 목소리 하나, 한국어 문장 하나, 10/24 측정
- 다섯 모델에 같은 참고 목소리(5.08초)를 주고 같은 한국어 문장을 읽게 했음
- 만든 음성은 Whisper로 다시 받아 적어 발음 오류(CER)를 쟀고, 화자 인식 모델(ECAPA)로 참고 목소리와 닮은 정도를 쟀음
| 모델 | 발음 오류 | 목소리 유사도 | 5초 음성 생성 | GPU 메모리 |
|---|---|---|---|---|
| OmniVoice | 0% | 0.812 | 2.2초 | 2.2GB |
| CosyVoice3 0.5B | 3.1% | 0.808 | 7.1초 | 3.6GB |
| VoxCPM2 | 0% | 0.783 | 17.1초 | 5.9GB |
| Chatterbox | 0% | 0.749 | 11.2초 | 3.6GB |
| GPT-SoVITS | 0% | 0.687 | 7.5초 | 1.9GB |
- OmniVoice가 가장 닮았고 가장 빨랐음. 실시간보다 두 배 넘게 빨라서 방문자가 기다릴 만함
- VoxCPM2는 논문에선 최상위였지만 3070에선 메모리를 5.9GB나 쓰고 17초가 걸렸음
- 3070은 8GB라 다섯 개를 다 올릴 수도 없음. 서비스엔 하나만 올리기로 함
- 한계도 있음. 문장 하나, 참고 목소리 하나로 잰 작은 시험임
- 게다가 참고 목소리는 실제 사람이 아니었음. 녹음이 아직 없어서 Chatterbox 기본 목소리로 동의 문장을 읽힌 임시 파일을 썼음
- 하나 더 걸린 것. 모델들을 사용자 폴더에 깔았더니 경로의 한글 때문에 음성 라이브러리가 깨졌음. 그래서 모델과 환경을 전부 영문 경로로 옮김
3070은 집에 있고 방문자는 밖에 있음
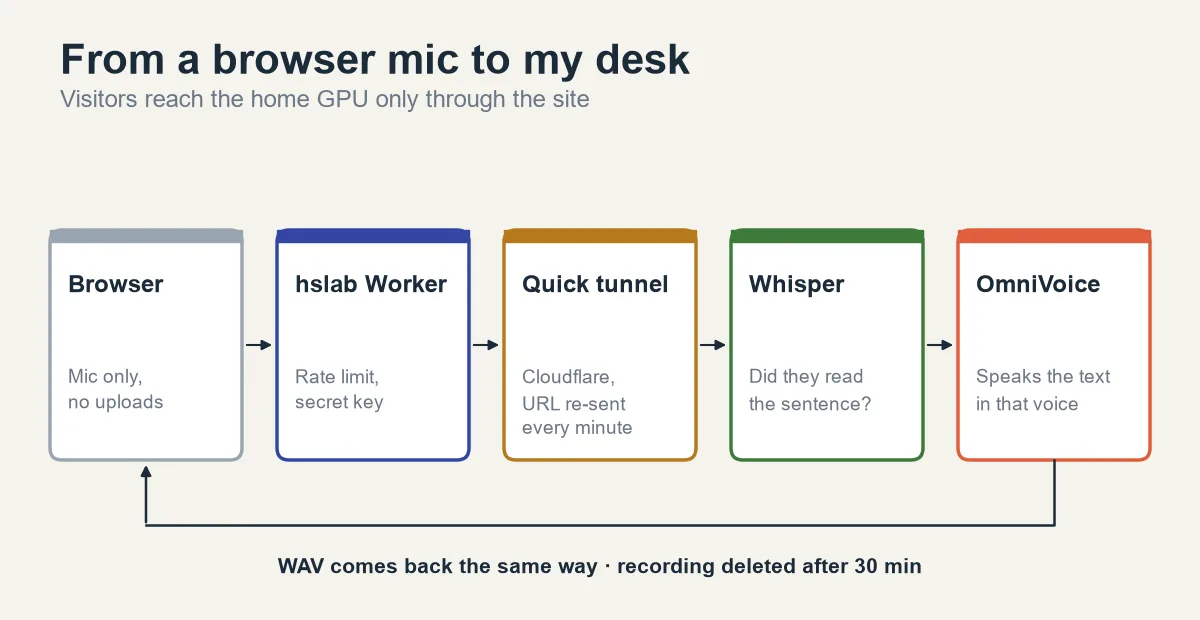
HSL 제작 — 방문자 요청이 집 GPU까지 가는 길
- GPU는 집 PC에 있으니, 사이트 서버(Cloudflare Worker)가 요청을 받아 터널로 집 PC에 넘김
- 터널은 Cloudflare 빠른 터널(quick tunnel)을 씀. 주소가 실행할 때마다 바뀌어서, 집 PC가 1분마다 지금 주소를 사이트 서버에 다시 알려 줌
- 집 PC와 사이트 서버만 아는 비밀 키가 맞아야 요청을 받음. 밖에서 터널 주소를 알아도 바로 못 씀
- PC가 꺼지면 페이지에 “지금은 잠시 쉬는 중”이 뜸
- 실제 사이트를 거쳐 끝까지 돌려 보니 녹음 확인 2.2초, 음성 생성 2.5초가 걸렸음
남의 목소리는 못 쓰게
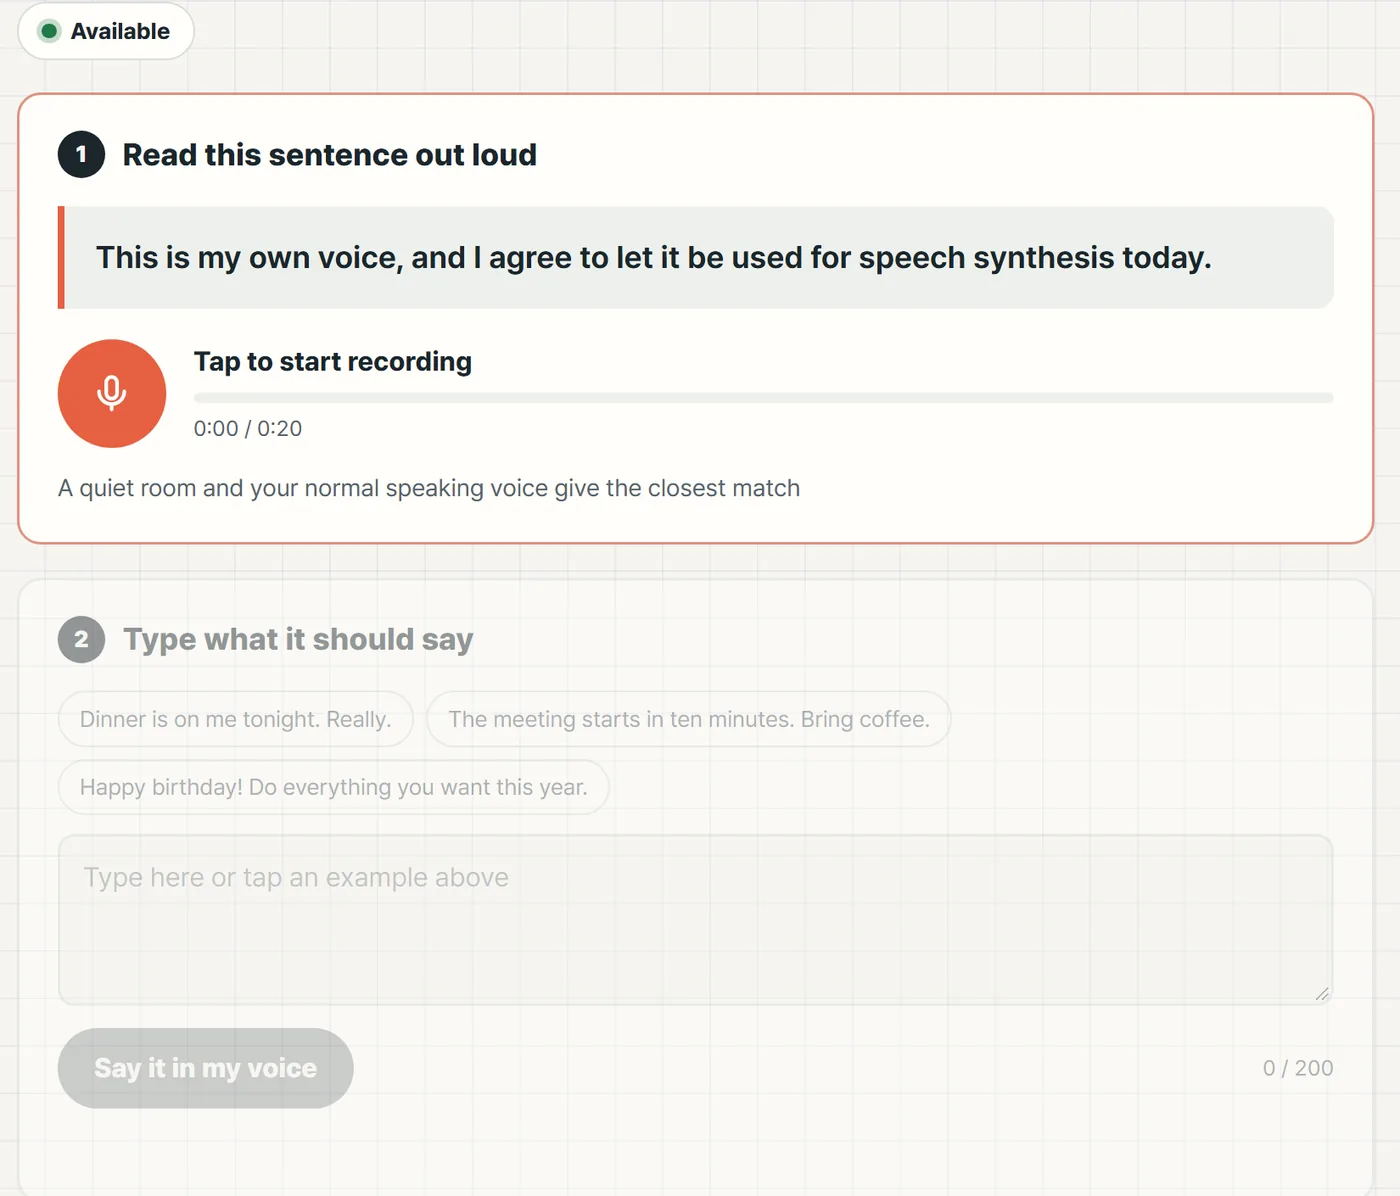
HSL 제작 — 프로젝트 페이지 영어판 녹음 화면, 10/27 기준
- 남의 목소리를 몰래 복제하는 데 쓰이면 안 되니, 파일 업로드는 아예 없음. 마이크로 직접 읽어야 함
- 읽을 문장은 “이 목소리는 제 목소리이고, 오늘 이 문장으로 음성 합성을 만드는 데 동의합니다”로 정해 둠
- 녹음이 오면 Whisper large-v3-turbo가 받아 적고, 정해진 문장과 35% 넘게 다르면 거절함
score = cer(norm(CONSENT[lang], lang), norm(heard, lang))
if score > 0.35:
raise HTTPException(422, f"mismatch:{heard[:120]}")- 녹음 길이는 2~20초만 받고, 너무 작은 소리도 거절함
- 통과한 녹음은 임시 폴더에 30분만 두고 지움. 학습에 쓰지 않고, 입력한 문장도 저장하지 않음
- 요청 횟수는 IP를 해시로 바꾼 값으로만 셈. 한 시간에 녹음 확인 10번, 생성 40번까지임
다시 한다면
- 후보는 최신 논문 비교표부터 보고 고를 것. 처음 고른 셋은 한 세대 전 모델이었음
- 참고 목소리는 처음부터 실제 사람 녹음으로 잴 것. 2편에서 내 실제 녹음과 비교해 보니 유사도가 0.72~0.82로 나왔음
- 재부팅하면 음성 서버와 터널을 손으로 다시 띄워야 함. 로그인할 때 자동으로 켜지게 해 둘 것
- 고정 주소 터널(named tunnel)을 쓰면 1분마다 주소를 다시 알리는 장치도 필요 없을 것 같음
- 2편은 이 목소리로 유튜브 쇼츠 나레이션을 만들고, LoRA 학습까지 해 본 이야기임. 직접 써 보려면 프로젝트 페이지