01 이상 탐지 · 상수도·상수도사업본부 · AI 스타트업 재직 시
유량 데이터로 누수 찾기
상수도 관망의 유량 데이터로 누수 의심 구역을 실시간으로 알려 주는 탐지 모델과 대시보드. 누수 시작 시점조차 기록되지 않은 현장 데이터를 학습 가능한 형태로 다시 정의하는 것부터 시작함.
PythonXGBoostEMAFeature engineeringREST API
- 90%
- Accuracy+19%p
- 0.63
- F1 score+0.32
- 20+
- 파생 변수
water-leak-detection / dashboard
실시간 유량 모니터링 · AI 탐지누수 의심 2건
실시간 유량EMA 기준선누수 의심
| 시간 | 구역 | 상태 | 신뢰도 |
|---|
| 03:20 | A-12 | 누수 의심 | 92% |
| 04:15 | B-05 | 누수 의심 | 88% |
| 05:30 | C-09 | 주의 필요 | 65% |
서비스 화면을 다시 그린 예시 EMA 기준선 시각화
유량 그래프에 동적 기준선을 함께 그려 현장 담당자가 이상 여부를 바로 판단
AI 탐지 알림 목록
누수 의심 구간을 실시간 알림으로 제공해 수동 감시 업무를 자동화
REST API 연동
분석 결과를 API로 제공해 기존 통합관제시스템과 연동
예측 결과를 담당자가 바로 쓸 수 있는 서비스 형태로 납품
-
문제 1누수 데이터 정의
기준이 모호한 현장 기록을 학습 데이터로
Problem
누수 시점이 기록되지 않음
- "복구 완료" 기록만 있고 실제 누수 시작 시점은 없음
- 복구일 기준으로 학습하면 누수가 진행 중인 패턴을 정상으로 잘못 배움
Solution
데이터 역추적 라벨링
- 구간 재정의
- 복구 1일 전은 비정상, 복구 1주일 뒤부터는 정상 구간으로 라벨링
- 운영 맥락 결합
- 계절·요일·수압 같은 운영 변수를 붙여 진짜 누수 패턴만 남김
누수 시작 시점 미기록 비정상 제외 정상
? 복구 완료 +1주
복구 1일 전 → 비정상
복구 1주 후부터 → 정상
데이터가 없는 문제를 분석으로 풀어, 불완전한 기록을 학습 가능한 데이터셋으로 재정의함
-
문제 2누수 판단 기준
경험으로 그은 직선을 데이터 기반 곡선으로
Problem
고정된 직선 기준
- 야간 최소유량(MNF) 제한선을 과거 경험에 기대 직선으로 일괄 설정
- 계절이나 물 사용량 변화를 반영하지 못해 정상 유량을 누수로 오인하는 일이 잦음
Solution
EMA 동적 기준선
- EMA
- 최근 데이터에 가중치를 더 주는 지수이동평균으로 움직이는 추세선 개발
- 계절성 반영
- 직선 대신 데이터 흐름을 따르는 기준선으로 오탐을 크게 줄임
직관에 기대던 기준을 통계적 기준으로 바꿔 알림의 신뢰도를 높임
-
문제 3모델 고도화
비선형 상호작용까지 보는 분류 모델
Problem
단일 기준선의 한계
- 누수는 유량뿐 아니라 요일·계절·시간대·수압이 비선형으로 얽혀 나타남
- 단일 변수 기준선으로는 미세 누수나 패턴 변화를 잡기 어려움
Solution
AI 분류 모델 도입
- Feature engineering
- 시간·요일·계절, 이동평균 차이, 수압 변동성 등 20개 이상 파생 변수
- XGBoost
- 앙상블 모델로 비선형 패턴 분류 성능을 끌어올림
- 임계값 최적화
- Precision-Recall 균형을 보고 임계값을 조정해 오탐 최소화
정확도 71% → 90%, F1 0.31 → 0.63
02 시계열 예측 · 스마트팜·2025 · 스마트팜 기업
온실 환경 시계열 예측 AI
온실 관리 소프트웨어 안에서 미래 24시간의 온도·환경 변화를 예측하고, 그 예측으로 천창·난방기 작동 시점을 미리 시뮬레이션하는 모델. 환경·제어·기상 예보가 얽힌 다변량 시계열을 구조부터 다시 설계함.
PyTorchPatchTSTMulti-stream embeddingTrend decomposition
- 92%
- R²안정 조건
- 1.1
- MAE (℃)안정 조건
- 1/3
- 입력 변수 수
smart-greenhouse / control-simulation
온실 환경 예측 · 시뮬레이션 (온도)AI 제어 모드 ON
실측 온도AI 예측 온도
| 시간 | 예상 온도 | 천창 | 난방기 |
|---|
| 14:00 | 24.5℃ | 개방 30% | OFF |
| 15:00 | 23.8℃ | 개방 10% | OFF |
| 16:00 | 21.2℃ | 닫힘 | ON (1단계) |
서비스 화면을 다시 그린 예시 온실 관리 SW 통합
기존 통합 관제 시스템에 예측 모델을 탑재해 미래 24시간 환경 변화를 실시간 확인
장치 제어 시뮬레이션
천창·난방기 작동 시점을 시뮬레이션해 능동적인 생육 관리를 지원
운영 가능한 성능
MAE 1.1, R² 92%로 환절기에도 안정적인 제어 가이드 제공
농가의 실제 의사결정을 돕는 운영 서비스로 완성
-
문제 1다변량 학습
트랜스포머와 스트림 임베딩으로 기존 모델의 한계를 넘음
Problem
RNN·LSTM의 다변량 한계
- 입력 변수가 많고 복잡해질수록 RNN 계열 모델의 성능이 떨어짐
- 환경·제어·기상 예보 변수의 성격을 구분하지 못하고 한데 섞음
Solution
구조 재설계
- PatchTST
- 시계열을 패치 단위로 처리해 긴 맥락을 잡고 연산 효율을 높임
- Multi-stream embedding
- 환경·제어·기상 변수군을 독립 스트림으로 넣어 각 특성을 유지하며 상호작용을 학습
환경제어 설정값기상 예보
→Multi-stream embedding→PatchTST→미래 24시간 예측 환경과 제어 변수의 상호작용을 구조적으로 학습해 예측 정확도를 끌어올림
-
문제 2제어 데이터 구조화
복잡한 제어 설정값을 학습하기 좋은 구조로
Problem
반정형 데이터와 차원의 저주
- 장치별·시간대별 설정값이 복잡하게 얽혀 시계열 모델 입력으로 비효율적
- 단순 전개하면 변수가 폭증해 학습이 느려지고 과적합 위험이 커짐
Solution
도메인 기반 압축
- 제어 주기 매핑
- 온실 제어 로직(4~6구간)을 반영해 시간대별 설정값을 재할당
- 변수 1/3로 축소
- 통합·재구조화로 핵심 정보는 지키고 변수 차원을 크게 줄임
도메인 지식을 데이터 구조 설계에 반영해 최적화
-
문제 3환경 적응성
계절과 환경 변화에도 버티는 예측 구조
Problem
환경 변화 시 오차 급증
- 계절 변화나 새 온실 설정값으로 데이터 분포가 바뀌면 성능이 급격히 떨어짐
- 적응하려면 매번 대량 데이터를 다시 모아 재학습해야 하는 비효율
Solution
추세 분해 (Trend decomposition)
- 추세
- 입력 길이만큼의 이동평균을 베이스라인으로 써서 급격한 변화를 완충
- 잔차 예측
- 전체 값 대신 변동분만 예측해 학습 난이도를 낮춤
- Autoformer
- 아이디어를 적용해 변화 조건에서 성능을 80~100% 개선
MAE (℃)낮을수록 좋음
안정 조건 1.1
변화 조건 1.7
환경이 바뀌어도 R² 84%, MAE 1.7로 오차 범위를 유지
03 LLM Agent · 스마트팜·2025 · 스마트팜 기업
LLM Agent가 쓰는 AI 컨설팅 리포트
컨설턴트의 진단 과정을 LLM Agent 워크플로로 옮겨, 농가마다 그래프·표·실행 제언이 담긴 주간 컨설팅 리포트를 자동으로 만드는 서비스. 실제 딸기 농가에 PDF와 웹 링크로 배포하고 피드백을 받아 고도화 중.
LangGraphLLM AgentPython그래프·표 자동 생성
- 주간
- 농가별 리포트
- 24/7
- 상시 컨설팅
- PDF · Web
- 현장 배포
smart-farm-consulting / report.pdf
딸기 생육 주간 컨설팅 리포트3월 2주차
주간 평균 온도 분석
주간 평균 온도18.5℃ 적정
주간 평균 습도82.0% 과습
Action plan 야간 습도 90% 이상이 이어지는 구간이 있어 잿빛곰팡이병 위험이 높음.
– 야간 난방 설정 온도 1℃ 상향
– 일출 전 30분 환기 추가
서비스 화면을 다시 그린 예시 그래프·표 자동 생성
텍스트 답변이 아니라 시계열 그래프와 요약표가 들어간 리포트를 완전 자동으로 생성
실행 가능한 제언
"난방 온도 1℃ 상향", "환기 시간 추가"처럼 바로 실행할 수 있는 제어 가이드
현장 배포
딸기 농가에 PDF·웹 링크로 주간 배포, 현장 피드백으로 계속 고도화
현장에서 전문가의 역할을 보조하는 서비스
-
문제 1컨설팅 접근성
전문가 부족을 AI로 확장해 해결
Problem
공급 부족
- 스마트팜 농가는 빠르게 늘지만 전문 컨설턴트는 부족하고, 소규모 농가에는 비용 부담
- 방문할 때만 조언이 가능해 데이터 변화를 계속 지켜보기 어려움
Solution
전문성 확장
- 컨설팅 로직 이식
- 현업 컨설턴트의 진단 프로세스를 LangGraph 에이전트 워크플로로 구현
- 상시 컨설팅
- 시간과 장소 제약 없이 누구나 받을 수 있는 컨설팅
환경·생육 데이터컨설턴트 진단 로직
→LangGraph 에이전트→주간 리포트 AI는 전문가를 대체하지 않고 노하우를 더 멀리 전달하는 도구
-
문제 2리포트 유연성
고정 양식 대신 상황에 맞춰 다시 짜는 리포트
Problem
경직된 템플릿
- 모든 농가에 같은 템플릿을 써서 특이사항이나 돌발 변수를 담지 못함
- 수치만 나열할 뿐 현상이 왜 생겼는지 맥락 설명이 부족
Solution
LLM Agent 동적 생성
- 동적 목차
- 농가 상황과 데이터에 따라 목차와 내용을 실시간으로 재구성
- 복합 구성
- 설명에 맞는 그래프와 표를 에이전트가 스스로 판단해 배치
정성적인 기준과 요구사항까지 반영할 수 있는 리포팅 방식
실제 샘플에이전트가 만든 주간 리포트 한 페이지
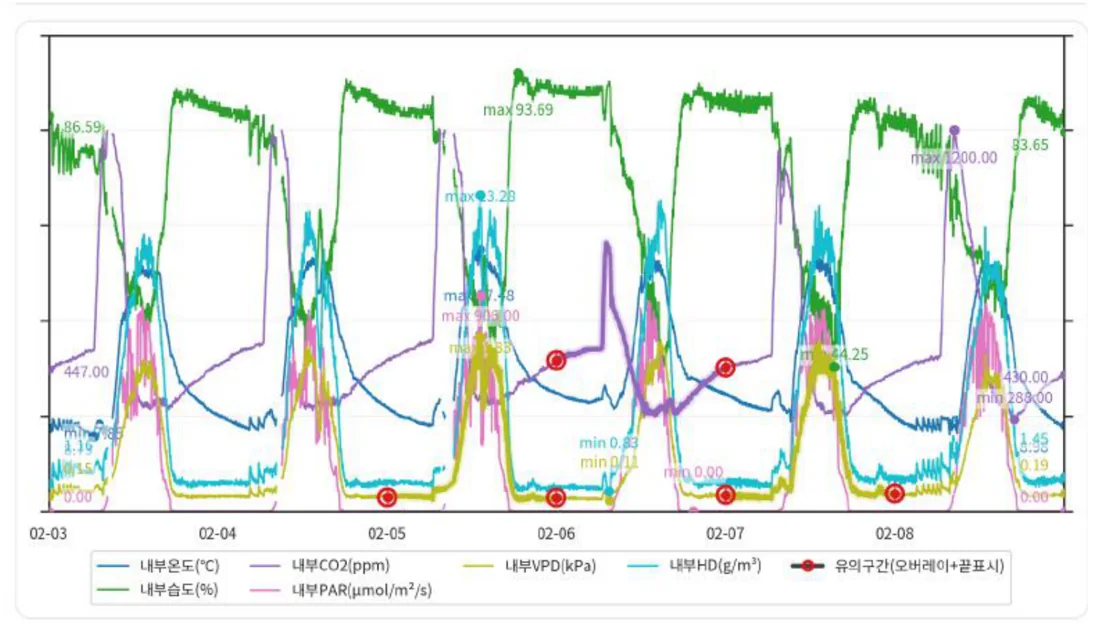
내부 온도 세부 분석 결과
일별 그래프·통계
- 주간 평균 18.27~20.36℃, 주간 최고 25.97~27.48℃
- 야간 평균 9.94~12.54℃, 야간 최저 7.85~8.91℃인 날이 여러 번
- 전주 대비 평균 +1.27℃로 소폭 상승
관리 범위 코멘트
- 후기 수확기 기준 주간 16~24℃, 야간 10~14℃를 관리 범위로 두는 편이 안전
- 야간 8℃대가 반복되면 과실 비대·착색에 불리해 "보온 우선, 난방 최소"로 방어 필요
관련 변수 분석
- 낮에는 PAR 상승과 함께 RH가 44%까지 떨어지며 VPD가 1.8kPa까지 상승
- 밤에는 RH 80~93%, VPD 0.11~0.28로 결로 위험만 관리하면 되는 구조
R 논문·2020–2024
주요 연구
현장 문제에서 출발한 논문 4편. 바다 수온, 치과 3D 스캔, 건설 계약서, 악성 댓글처럼 데이터는 제각각이지만, 실제 데이터의 빈틈을 메우는 방법을 찾는 연구임.
- 4
- 주요 논문
- 3
- KCI 학술지
- 1
- 기업 공동연구
2024.11학술대회
기상예보를 붙인 해양 수온 예측
해양환경 예측을 위한 다중그룹 시계열 예측 AI 개발: 기상예보 데이터 결합 및 딥러닝 방법론 기반 해양 수온 예측
R² 0.992MAE 0.383
- 문제
- 수온 상승으로 적조와 어업 피해가 커지는데, 기존 모델은 한 해역에 과적합되고 새 해역엔 1–2년치 데이터가 필요했음
- 데이터
- 국내 여러 해역의 해양 관측 시계열과 기상 예보
- 방법
- 여러 해역을 함께 배우는 다중 그룹 GRU 인코더-디코더, 디코더에 미래 기상 예보를 결합
- 결과
- R² 0.9919, MAE 0.3832로 비교 모델 중 가장 높음
2024.12KCI
실제 임상 3D 치아 스캔 세분화
실무 기반 3D 치아 스캔 데이터 세분화를 위한 딥러닝 모델 성능 평가: MeshSegNet과 DilatedToothSegNet 모델 활용
MDSC 0.919상악 기준 · 하악 0.908
- 문제
- 기존 연구는 온전한 구강만 학습해서, 크라운·임플란트가 있거나 일부만 찍은 실제 스캔에서 잘 안 됨
- 데이터
- 치과 병원 구강 스캔 910건(상악 475, 하악 435)을 치은과 치아 14개, 15개 클래스로 라벨링
- 방법
- MeshSegNet과 DilatedToothSegNet을 같은 조건으로 학습하고 그래프 컷 후처리로 비교
- 결과
- DilatedToothSegNet(16,000 셀)이 DSC·mIoU 모두 MeshSegNet보다 2–3.5% 높음
2023.11KCI현대엔지니어링 공동연구
건설 입찰 문서의 계약 조항 분류
EPC ITB 프로젝트의 위험관리를 위한 문서 조항 분류 모델 연구: 딥러닝 기반 앙상블 기법 활용
Top-5 93%정확도 76% · 57개 조항
- 문제
- 100쪽 안팎의 입찰 안내서(ITB)를 짧은 입찰 기간에 다 검토하기 어렵고, 위험 조항만 골라내는 기존 방식은 데이터 부족으로 실무에 못 씀
- 데이터
- EPC 계약 문서 77건과 공개 법률·계약 말뭉치 12GB로 사전학습, 23건을 FIDIC 57개 조항으로 라벨링한 6,190건으로 미세조정
- 방법
- 직접 사전학습한 ITB-ELECTRA와 Legal-BERT 앙상블, 5개 국어 역번역과 MLM 데이터 증강
- 결과
- 정확도 76.38%, 상위 5개 후보 안에 정답이 있는 비율 93.03%
2020.12KCI
악성 댓글을 7개 유형으로 분류
Bias & Hate Speech Detection Using Deep Learning: Multi-channel CNN Modeling with Attention
F1 0.703Ko-BERT 0.684
- 문제
- 단어 사전 기반 탐지는 신조어와 문맥을 놓치고, 혐오·차별 유형을 구분하지 못해 제재 근거를 주기 어려움
- 데이터
- 연예 뉴스 댓글 203만 건으로 임베딩을 학습하고, 13만 7천 건을 비난·욕설·성별·정치·연령·종교·인종으로 라벨링
- 방법
- 임베딩·Bi-LSTM·어텐션 3채널 CNN에 하이웨이 네트워크를 결합
- 결과
- 가중 F1 0.7032로 Ko-BERT(0.6843)보다 높고, 인종(0.610 vs 0.406)처럼 드문 유형에서 차이가 큼