한줄 평
미국 빅테크는 최상위 모델을 쌓아 두고 문을 닫는 방식으로 추격전을 끝내 가고 있고, 이 격차는 앞으로 더 벌어질 것으로 봄 (글쓴이 의견)
턱밑까지 왔던 중국, 다시 19점 차
- 최근 미·중 AI 격차가 많이 벌어졌다고 봄. AA 기준으로 중국이 턱밑까지 쫓아왔다가 다시 밀려났음 (글쓴이 의견)
- Artificial Analysis(AA) 지수 v4.3에선 1등과 Kimi K3.1 Pro의 차이가 3점뿐이었음 (AA v5 발표)
- Kimi K3.1 Pro는 중국 Moonshot의 모델로, AA가 오픈 웨이트로 분류한 모델 중 1등임. 가중치는 아직 안 풀렸음 (Dealroom)
- 10월 27일 지수가 v5로 바뀐 날 그 차이는 12점이 됐음. Opus 5.5가 58점, Kimi가 46점이었음
- 11월 9일 Fable 5.2가 65점을 찍으면서 같은 v5 안에서 19점까지 벌어졌음1 (AA 순위표)
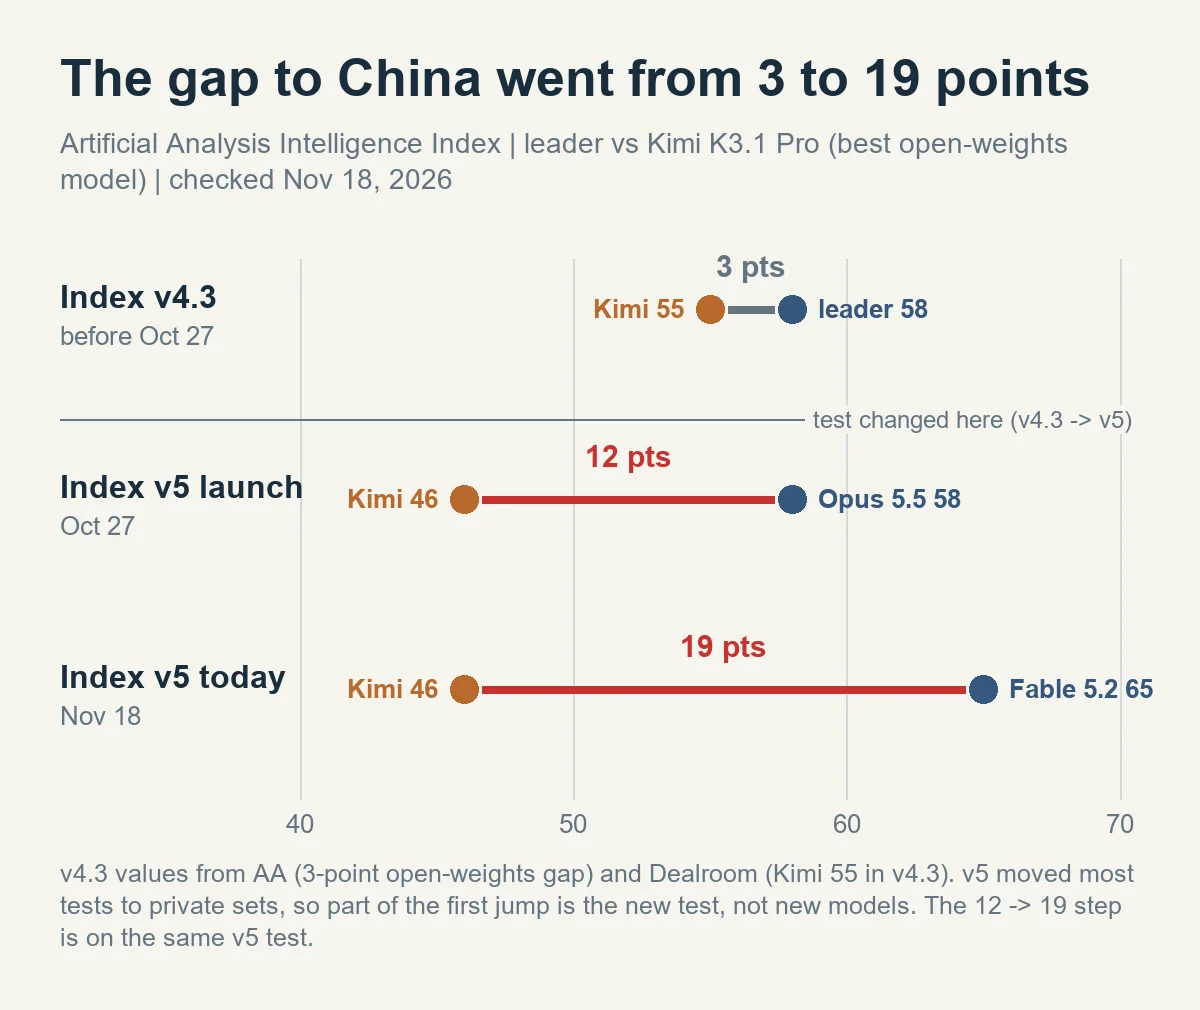
HSL 제작 — AA v5 발표, AA 순위표, Dealroom, 2026년 11월 18일 확인
- 가중치를 받을 수 있는 중국 모델 최고점은 DeepSeek V4.1 Flash의 33점임
- 미국의 작은 모델 Claude Haiku 5.5(36점)보다도 낮음
중국의 지름길은 Claude·GPT의 답안이었음
- 중국은 자체 모델도 개선하지만, Claude와 GPT의 질문·답변을 추가 학습해 근처까지라도 따라가는 전략을 썼다고 봄 (글쓴이 의견)
- 강한 모델의 답으로 약한 모델을 가르치는 방법을 증류(distillation)라고 함
- 2월 23일 Anthropic은 DeepSeek·Moonshot·MiniMax가 Claude를 대규모로 증류했다고 발표했음 (Anthropic)
- 가짜 계정 약 2만 4천 개로 1,600만 건 넘게 대화를 뽑아 갔다고 함
- 회사별로는 MiniMax 1,300만 건, Moonshot 340만 건, DeepSeek 15만 건 이상이었음2
- 노린 건 에이전트 추론·도구 사용·코딩처럼 Claude가 가장 앞선 능력이었음
- DeepSeek은 Claude에게 답의 추론 과정을 단계별로 다시 써 달라고 해서 학습 데이터를 만들었다고 함
- OpenAI도 2월 12일 미 하원 중국특위에 DeepSeek이 증류로 "무임승차"한다는 메모를 보냈음 (TNW)
- 4월 23일엔 백악관 과학기술정책실(OSTP)이 중국의 "산업 규모" 증류를 공식 문제로 삼았음
미국은 문을 닫는 쪽을 택했음
- Anthropic과 OpenAI는 모델을 비공개하는 식으로 이 추격전의 전략을 잡고 있다고 봄 (글쓴이 의견)
- Anthropic은 먼저 Claude의 추론 과정을 요약해서만 보여 주기 시작했음 (Anthropic)
- 실험해 보니 전체 추론으로 증류한 모델은 SWE-bench Verified 80.4%, 요약본으로는 71.8%였음
- 8월 31일 이후 만든 API 계정은 Claude의 이전 대화 맥락을 고칠 수 없게 막았음. 추론을 빼내는 우회로를 끊으려는 조치임
- 추론을 빼내려는 요청은 생물무기 차단과 같은 수준의 분류기로 막고, 오탐률은 0.1% 미만이라고 함
- 10월 12일 Anthropic은 증류자가 가져가는 데이터가 약 90–99% 줄었다고 밝혔음
- 11월 9일 나온 Fable 5.2엔 역대 가장 강한 증류 방어를 넣었다고 적었음 (Anthropic)
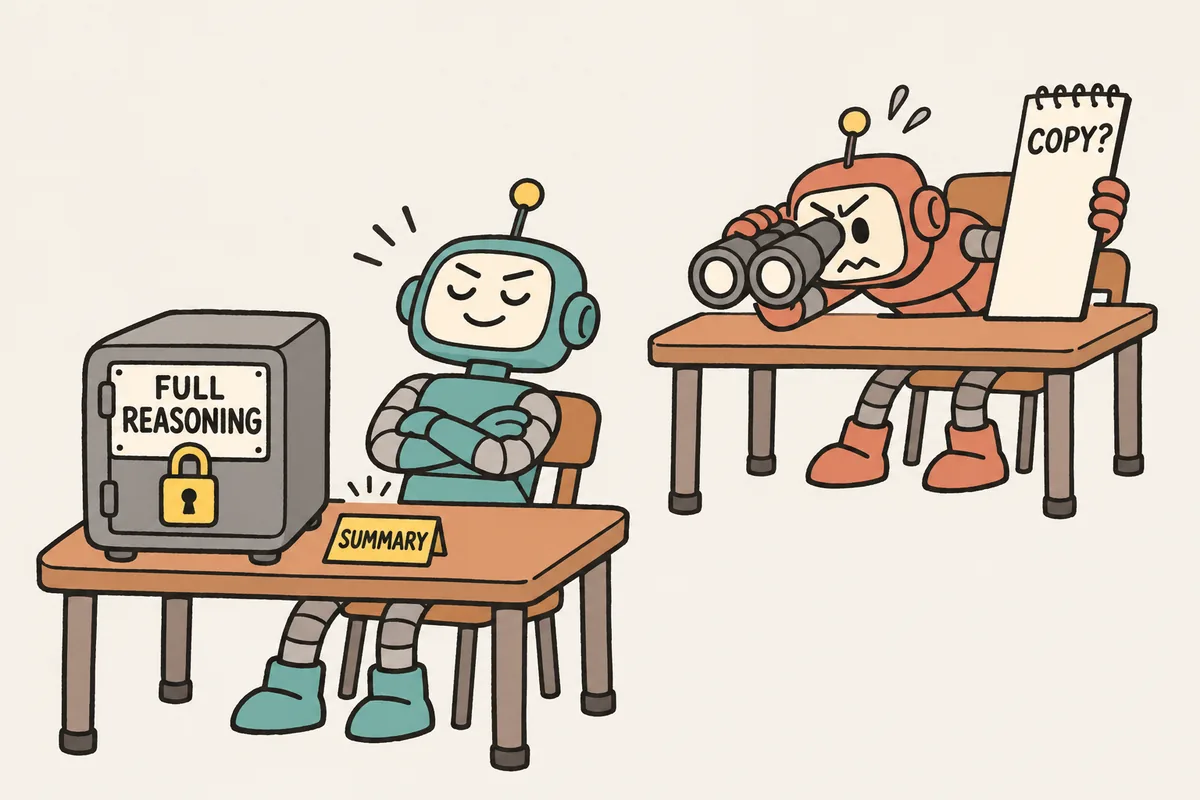
답안은 금고에
- 정부도 같은 방향으로 움직였음. 6월 12일 미 상무부는 Fable 5와 Mythos 5를 외국인이 못 쓰게 하라고 명령했음 (Spokesman-Review·Bloomberg)
- Anthropic은 명령을 지키려고 두 모델을 전 세계 모든 고객에게서 한동안 내렸음
- 미국 정부가 자국 회사 최전선 모델의 외국인 접근을 이렇게 넓게 막은 건 처음이었음
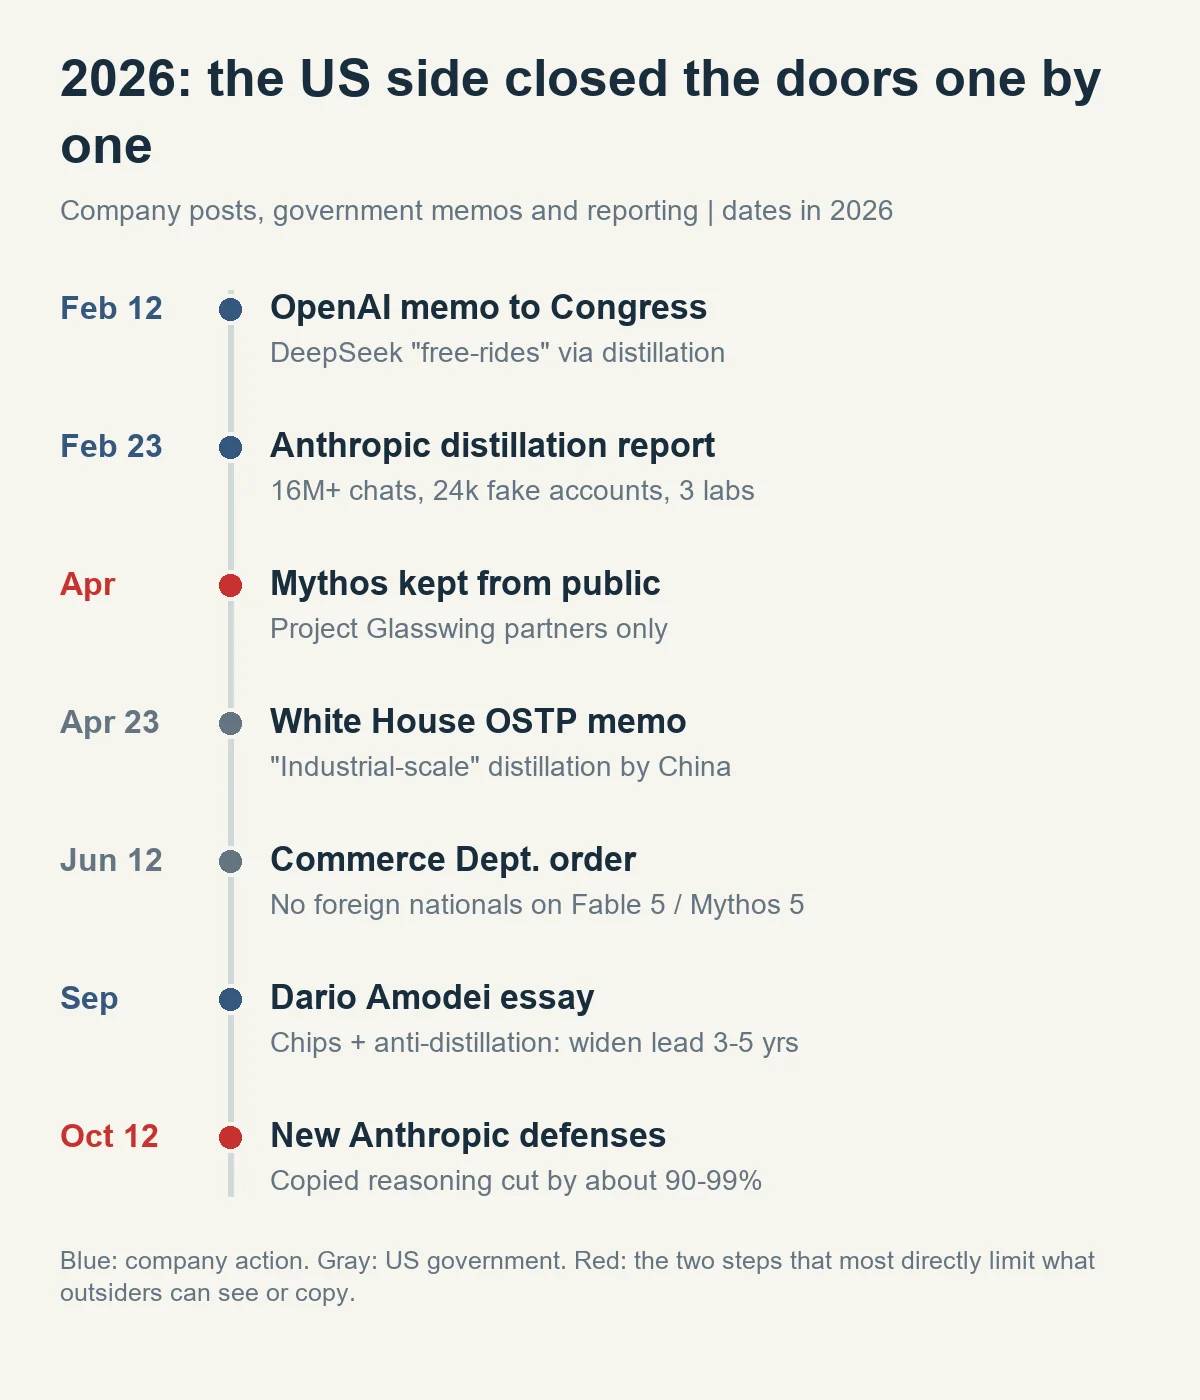
HSL 제작 — 각 회사 발표, 정부 메모, 보도 기준
- Anthropic CEO 에세이는 칩 통제와 증류 단속이 잘 되면 향후 3–5년 미국의 격차를 크게 벌릴 거라고 직접 적었음3 (Dario Amodei)
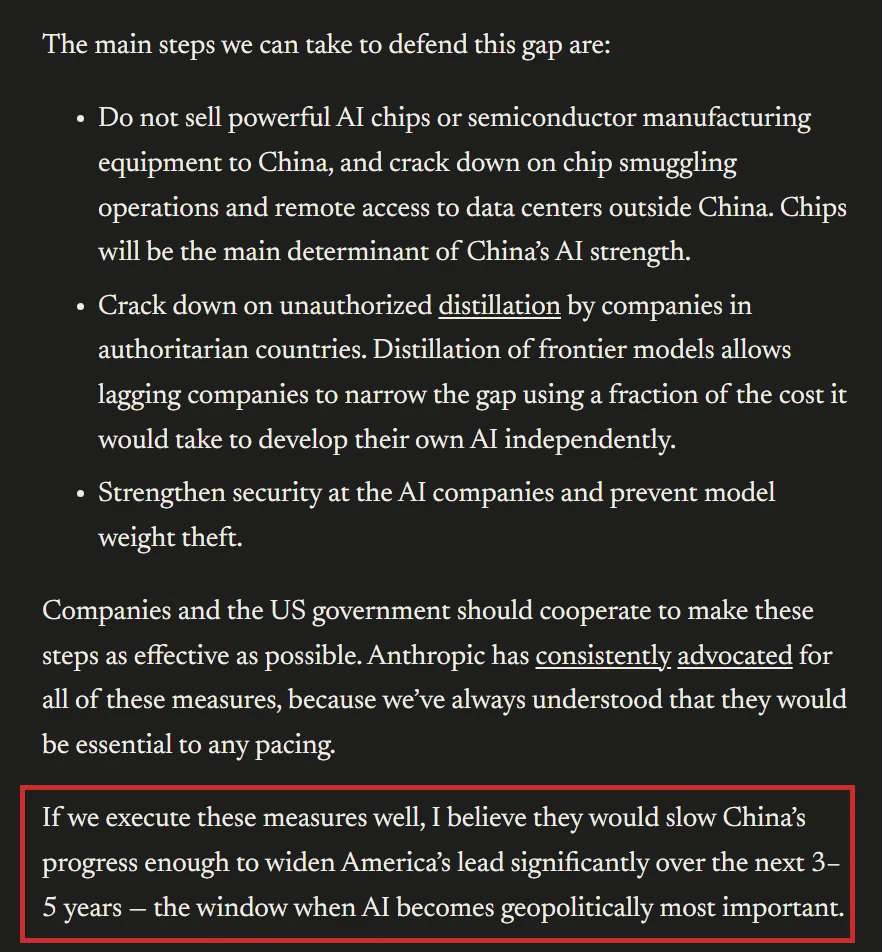
출처: Dario Amodei — We Must Pace the Frontier, 2026년 9월, 빨간 테두리는 HSL 추가
- 중국 관영 Global Times는 이 에세이를 미국 기술 우위를 지키려는 냉전식 각본이라고 비판했음 (Rest of World)
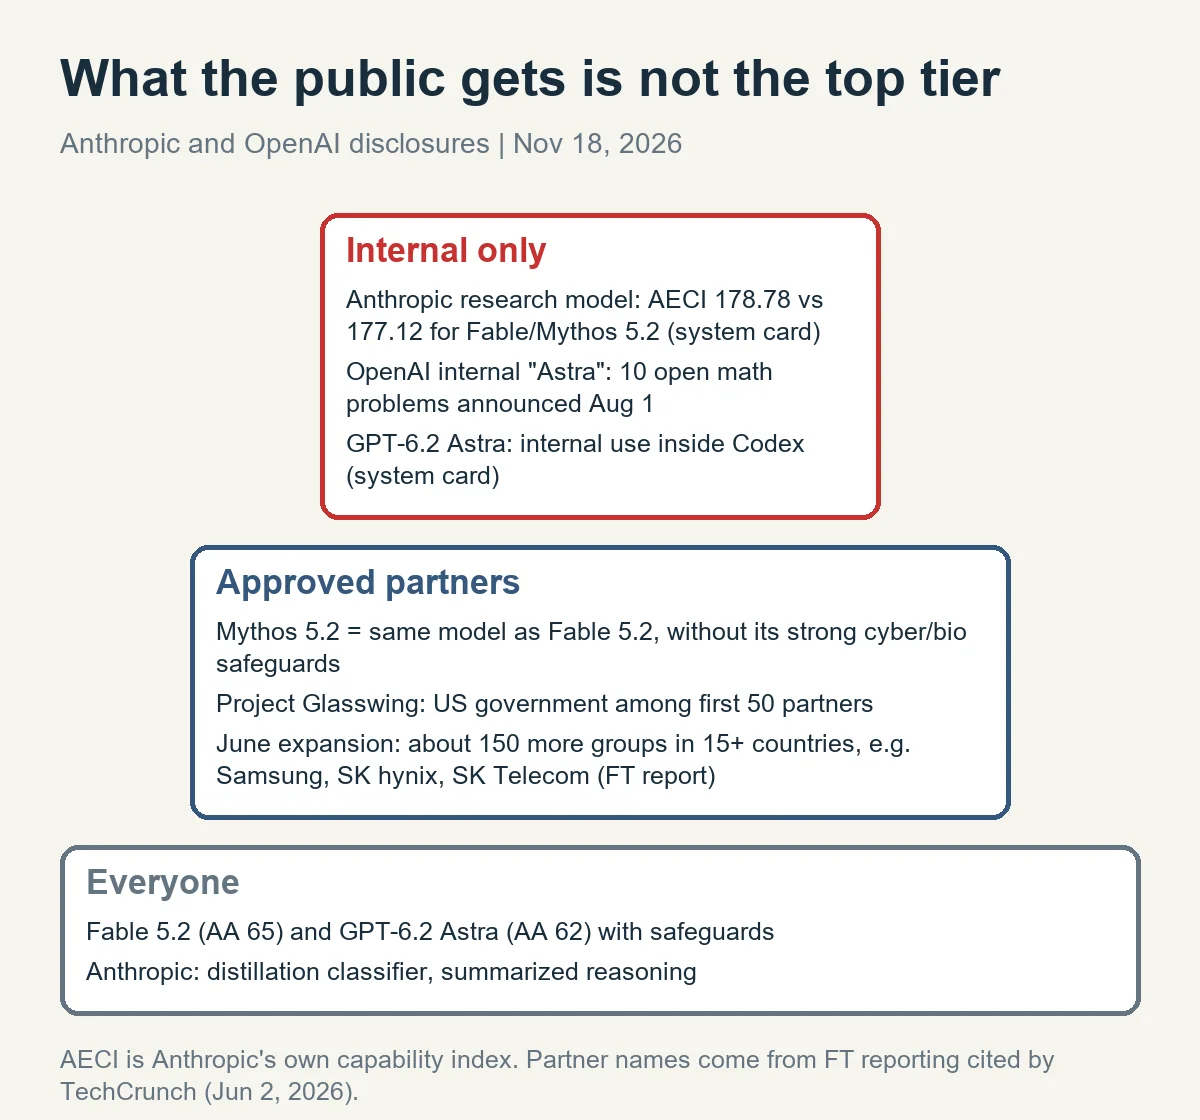
위 모델은 쌓아 두고 안에서 굴림
- 수학 난제를 풀어 화제가 된 Astra처럼, 상위 모델을 쌓아 두고 자체 개선하며 다른 나라와 격차를 벌린다고 봄 (글쓴이 의견)
- 정확히는 8월 1일 OpenAI가 발표한 미공개 내부 버전 Astra의 성과였음 (TNW)
- 10년 넘게 안 풀린 수학·이론 컴퓨터과학 문제 10개에 새 결과를 냈고, 기계로 검증되는 Lean 4 증명도 공개했음
- 발표 당시 OpenAI는 이 모델의 출시 시점을 밝히지 않았음
- GPT-6.2 Astra 시스템 카드엔 OpenAI가 Codex 안에서 이 모델의 내부 사용을 넓혀 왔다는 문장이 있음 (시스템 카드)
- 같은 카드는 GPT-6.2 Astra가 AI 자기개선 능력 High 기준을 넘긴 첫 외부 공개 모델이라고 적었음
- Dario Amodei도 올여름부터 AI가 다음 세대 AI를 만드는 재귀적 자기개선이 Anthropic을 포함해 업계에서 시작됐다고 썼음
- Anthropic도 페르마의 마지막 정리를 처음 형식화한 건 미공개 연구용 Claude였다고 밝혔음 (Anthropic)
- 외부 평가 기관 METR은 Anthropic이 최근 모델을 공개 전에 조금 더 오래 쥐고 있다고 적었음4 (METR)
HSL 제작 — Anthropic 시스템 카드, OpenAI 시스템 카드, TechCrunch 기준
가장 큰 증거는 Fable 5.2라는 번호
- 핵심 증거는 Fable 5.2라고 봄. 글로벌 1등이고 5.1과 차이도 커서 5.5라 해도 됐을 텐데 5.2인 건 내부에 이미 5.5가 있어서임 (글쓴이 의견)
- Fable 5.2는 AA 65점으로 1등이고, 같은 max 설정의 Fable 5.1(49점)보다 16점 높음 (지난 Fable 글)
- 그런데 Opus·Sonnet·Haiku는 이미 5.5인데 맨 위 Fable만 5.2임
- 시스템 카드엔 Mythos 5.2보다 점수가 높은 미공개 내부 연구 모델이 실려 있음. Anthropic 자체 지수로 178.78점 대 177.12점임5
Mythos는 아무나 못 씀
- Anthropic은 Mythos라는 최강 모델을 공개하지 않고, 아마 미 정부와 핵심 기업들이 쓰고 있을 것으로 봄. 그래서 AI 패권은 미국이 훨씬 강하게 가져갈 것 같음 (글쓴이 의견)
- Anthropic은 Fable과 Mythos가 같은 바탕 모델이라고 밝혔음 (Anthropic)
- Fable엔 사이버·생물 안전장치가 강하게 걸려 있고, Mythos는 신청해 승인받은 곳만 씀
- 4월 Mythos Preview 때부터 일반 공개 대신 Project Glasswing 파트너에게만 줬고, 첫 50곳에 미국 정부가 있었음 (TechCrunch)
- 6월엔 15개국 이상 약 150곳으로 넓혔고, 대상은 미국과 우호적인 나라들이었음
- FT 보도로는 삼성·SK하이닉스·SK텔레콤과 NATO도 여기에 들어갔음6
나라마다 남은 길은 둘
- 주도권을 가지려면 미국처럼 자체 AI를 계속 개발하든지, 미국과의 우호 관계로 비공개 최상위 AI를 돈 주고 써야 할 것임 (글쓴이 의견)
- 지금도 각국 자체 AI는 미국이 공개한 AI조차 따라가기 힘들다고 봄 (글쓴이 의견)
- 같은 AA v5 시험에서 미국 상위 모델은 60점대, 중국 1등은 46점임 (AA 순위표)
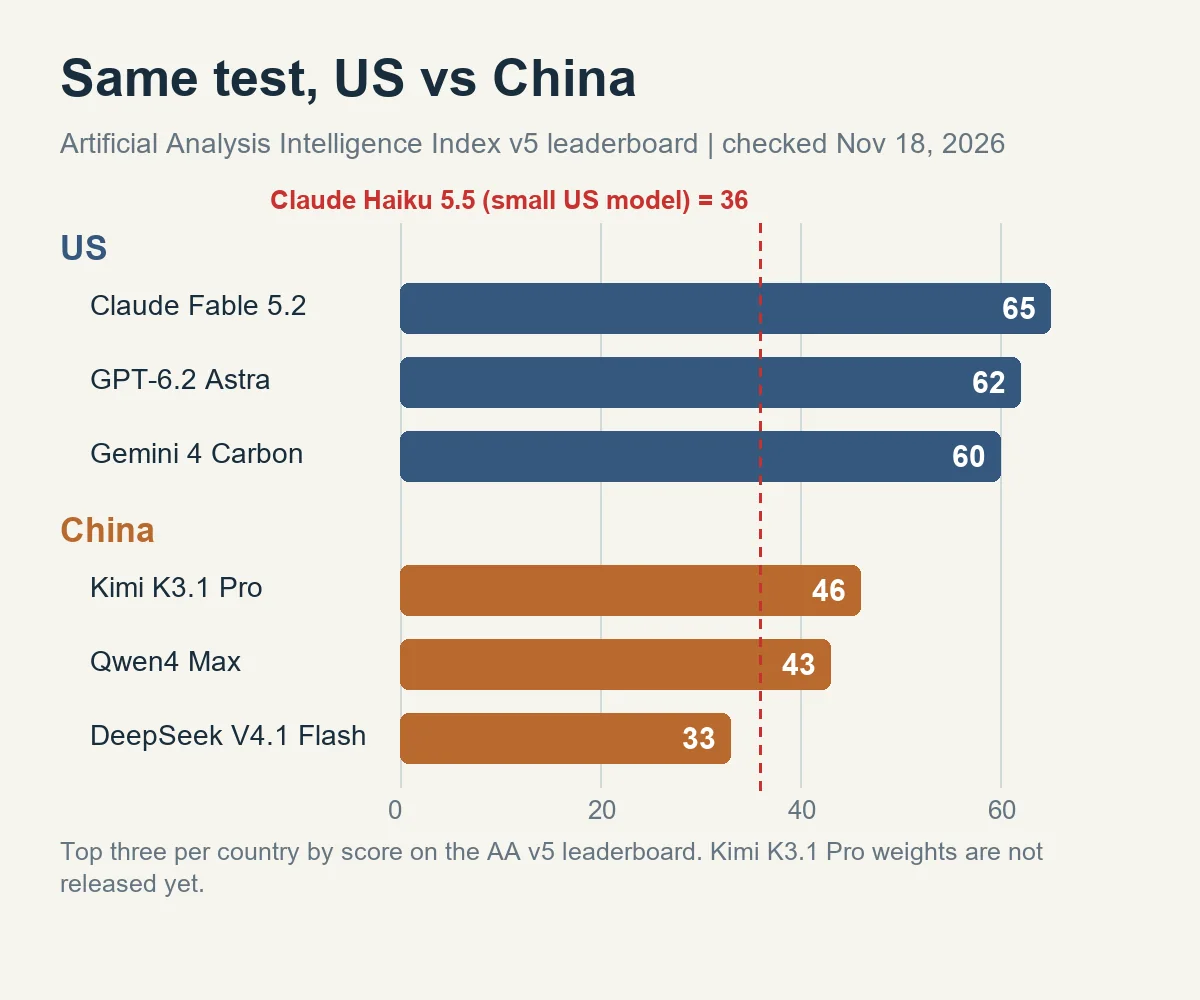
HSL 제작 — AA 순위표, 2026년 11월 18일 확인
- 한국 정부도 격차를 인정했음. 8월 과기정통부는 1등 모티프가 47점으로 Claude Opus 63점 등에 못 미쳤다고 밝혔음7 (머니투데이)
- 사업 목표인 프런티어 모델의 95% 수준이 되려면 57점 이상이 필요했다고 함
- 과기정통부 차관은 주요국이 AI 모델을 국가 안보 전략자산으로 삼는 움직임이 현실화됐다고 말했음
- 그래서 여러 팀에 GPU를 나눠 주는 대신 한 곳에 몰아 프런티어급 모델을 키우는 재편을 검토하고 있음
- 두 번째 길의 예도 이미 있음. 삼성·SK 같은 한국 기업은 보도대로라면 Glasswing으로 Mythos를 쓰고 있음
그래서 앞으로는?
- 첫 번째로 볼 건 다음 Fable 번호임. 이 그림이 맞다면 5.3이 아니라 5.5 이상이 나와야 함
- 두 번째는 AA 격차임. 미국 1등과 중국 1등의 19점 차가 Kimi K3.1 Pro 가중치 공개와 다음 DeepSeek 뒤에도 유지되는지 보면 됨
- 세 번째는 한국임. 독파모 3차 평가와 과기정통부의 프런티어 모델 사업 방향 발표가 남아 있음
- Anthropic은 11월 19일 나스닥 상장을 앞두고 있음. 이 그림이 맞다면 상장 뒤에도 최상위 모델은 한 번에 다 풀지 않을 것임
- Dario Amodei가 격차가 가장 중요하다고 본 기간은 향후 3–5년임
- 이 글은 AI 현업 개발자로서의 개인 의견이고, 훈수와 비판 환영함 (글쓴이 의견)
Q&A 또 궁금한 것은?
- Q. Mythos가 Fable보다 센 숨겨진 모델임?
- 아님. Anthropic 발표로는 같은 모델이고 안전장치와 쓸 수 있는 대상만 다름
- 점수만 공개된 진짜 미공개 모델은 시스템 카드의 내부 연구 모델임
- Q. 19점 차면 중국 모델이 나빠졌다는 뜻임?
- 아님. 3점에서 12점은 시험이 비공개 문제로 바뀐 영향이 크고, 12점에서 19점은 미국 모델이 오른 결과임
- Q. 증류는 불법임?
- 학습 기법 자체는 업계가 흔히 씀. 문제가 된 건 약관을 어기고 가짜 계정으로 남의 모델을 대량 추출한 경우임
- 법적 지위는 아직 정리되지 않았다는 평가가 많음 (TNW)
Footnotes
-
※ 3점→12점에는 시험 개편(비공개 문제 60%) 영향도 섞여 있음 (Dealroom). 다른 잣대로는 차이가 더 작게 나옴: Stanford AI Index 2.7% (TNW), Epoch AI 평균 7개월 (Epoch AI) ↩
-
※ Anthropic 측 발표 수치이고, 해당 회사들의 입장은 확인되지 않음 ↩
-
※ Anthropic이 공식적으로 내세우는 이유는 안전임 ↩
-
※ METR 표현은 "조금 더 오래"이고, 정확한 기간은 확인되지 않음 ↩
-
※ 이 내부 모델이 5.5인지는 확인된 사실은 아님 ↩
-
※ 구체적인 사용처는 공개되지 않음 ↩
-
※ 당시 지수 버전 기준이라 지금 v5 점수와 바로 비교하긴 어려움 ↩