한줄 평
AA 지수 65점짜리를 5.2라고 부르는 건 5.5 자리를 비워 뒀다는 얘기로 보임. 더 큰 게 오고 있고, Anthropic은 이번에도 기대를 저버리지 않음 (글쓴이 의견)
65점을 찍었는데 번호는 0.1만 올랐음
- 11월 9일 Anthropic이 Claude Fable 5.2와 Mythos 5.2를 냈음 (Anthropic)
- 둘은 같은 모델이고, 사이버·생물 안전장치를 붙인 쪽이 누구나 쓰는 Fable임
- Artificial Analysis(AA) 지수에서 Fable 5.2 max가 65점으로 1등임 (AA 순위표)
- AA 지수는 지식 업무·코딩·과학·일반 지식을 25%씩 섞은 종합 점수임 (AA 방법론)
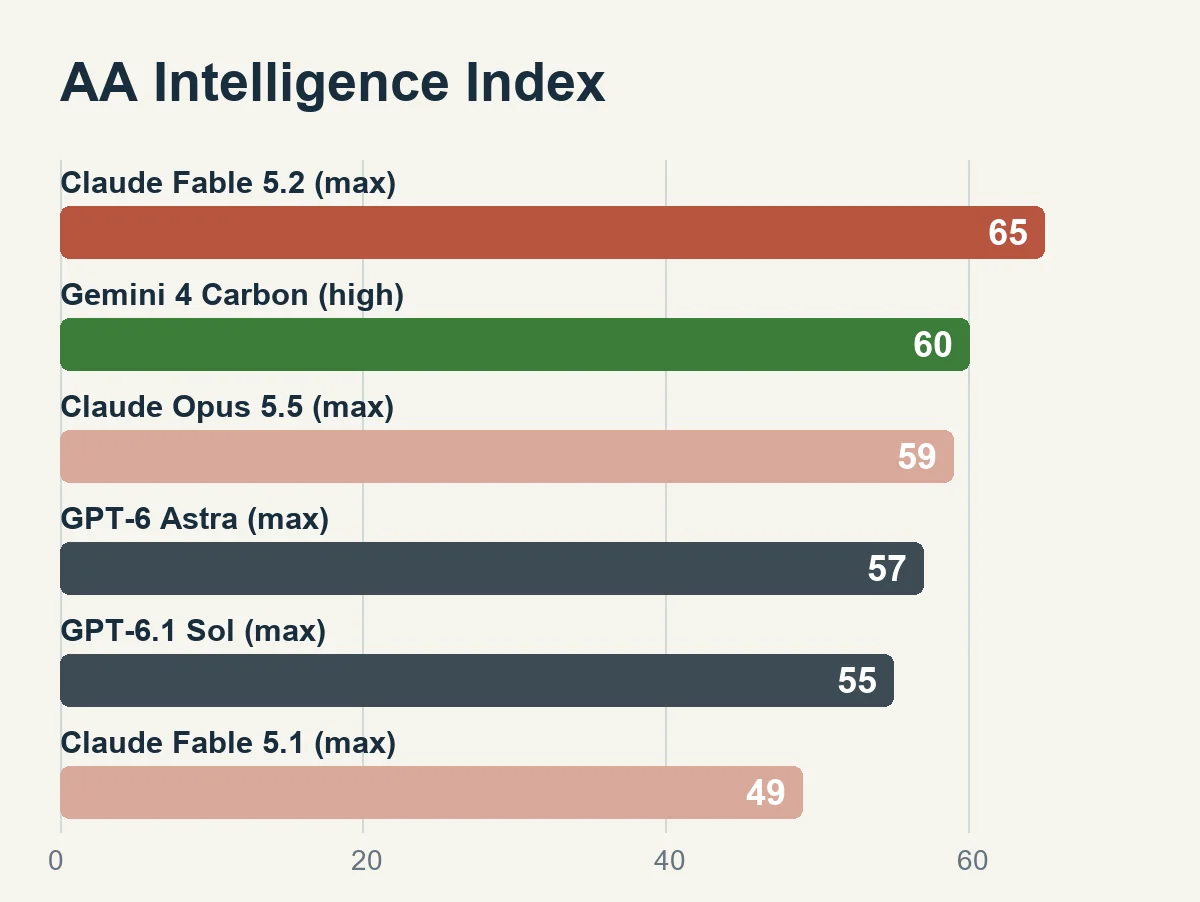
HSL 제작 — AA 순위표와 Fable 5.1 페이지, 2026년 11월 10일 확인
- 같은 max끼리 놓으면 5.1의 49점보다 16점 높음
- 그런데 번호는 5.1에서 5.2로 0.1만 올랐음
- 더 이상한 건 라인업임. Opus, Sonnet, Haiku는 이미 5.5인데 맨 위 Fable만 5.2임
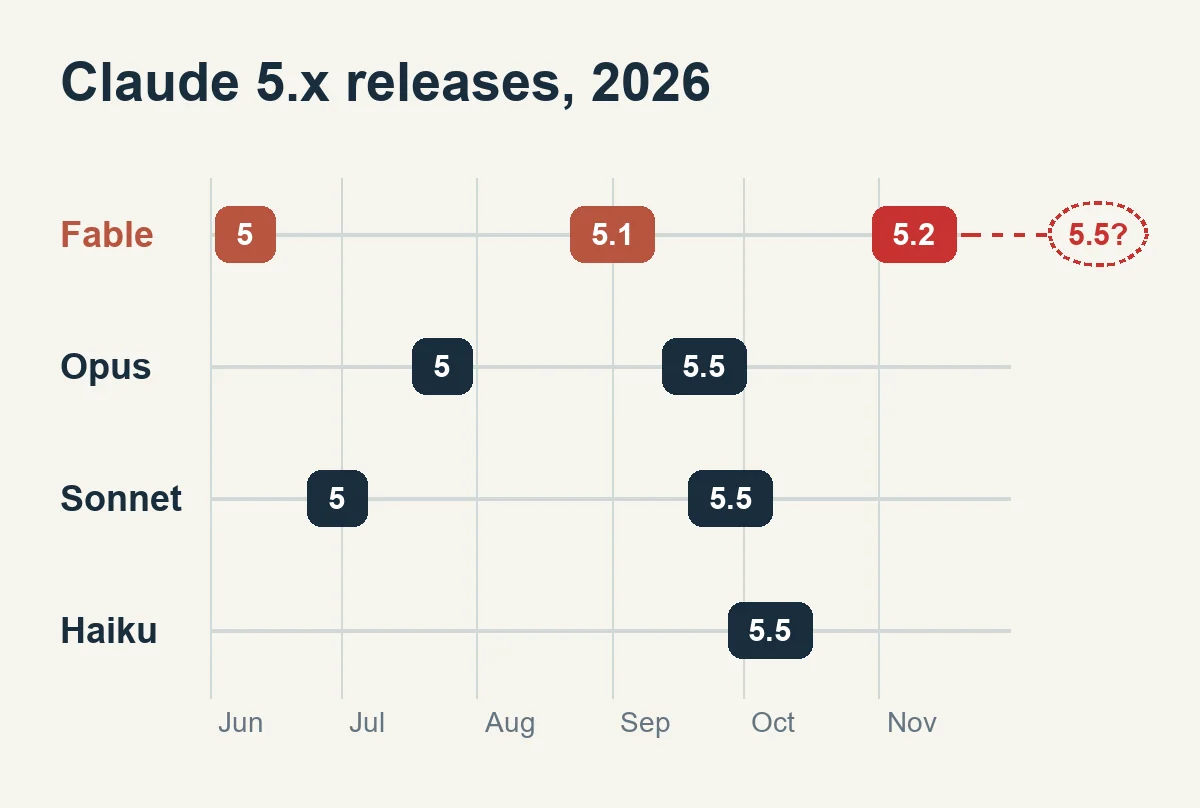
HSL 제작 — Anthropic 모델 문서와 각 모델 발표 기준. 5.5?는 글쓴이 추측이고 공식 일정이 아님
- 맨 위 모델이 아랫집보다 번호가 낮은 건 5.5를 일부러 남겨 둔 걸로 보임 (글쓴이 의견)
- 반론도 있음. Anthropic은 왜 5.2인지 설명한 적이 없고, 5에서 5.1, 5.2는 그냥 순서대로 붙인 번호일 수 있음
- 번호 오르는 폭이 점수 오르는 폭을 따라가야 한다는 규칙도 찾지 못했음
5.5는 이미 안에 있다고 봄
- 65점을 내고도 5.5를 안 썼으면, 5.5라고 부를 만한 게 따로 있다는 뜻 아닐까 싶음 (글쓴이 의견)
- 안에 더 센 모델이 있다는 건 Anthropic이 직접 적었음
- 이번 시스템 카드에 Mythos 5.2보다 "어느 정도 더 뛰어난" 미공개 내부 연구 모델의 점수가 처음 실렸음 (시스템 카드 2.3절)
| 모델 | AECI 점수 | 공개 여부 |
|---|---|---|
| Mythos 5.1 | 172.62 | 공개 |
| Opus 5.5 | 174.78 | 공개 |
| Mythos 5.2 (Fable 5.2와 같은 모델) | 177.12 | 공개 |
| 내부 연구 모델 | 178.78 | 미공개 |
AECI는 Anthropic이 자체 계산한 능력 지수. 출처는 시스템 카드 표 2.3.5.3.A
- 외부 평가 기관 METR도 Anthropic이 최근 모델을 공개 전에 조금 더 오래 쥐고 있다고 적었음
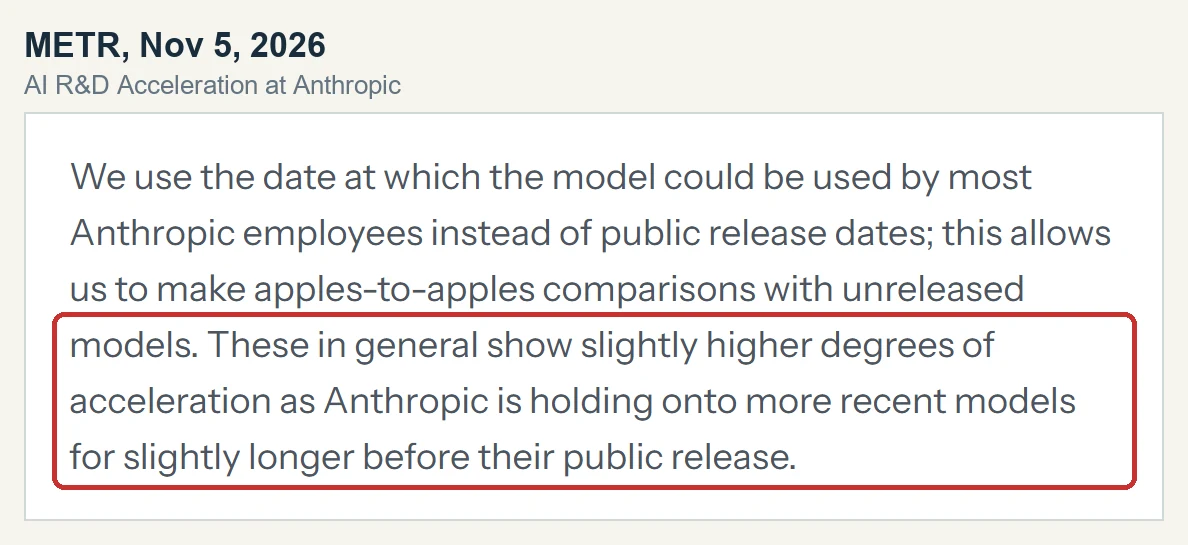
출처: METR — Independent Assessment of AI R&D Acceleration at Anthropic, 2026년 11월 5일, 빨간 테두리는 HSL 추가
- METR 보고서의 내부 전용 Model 4는 9–10월에 학습이 끝났고 AECI가 178.6점임
- 시스템 카드의 내부 모델과 점수가 거의 같아서 같은 모델로 보임 (글쓴이 추정)
- 앞으로 나올 모델의 예측치도 전체 보고서에 있었는데, 공개본에선 가려졌음
- Anthropic 상장 서류엔 개발한 모델을 전부 일반에 공개하진 않는다고 적혀 있음 (S-1)
- 다만 이 내부 모델이 곧 5.5라는 증거는 없음. 시스템 카드는 이름도 출시 계획도 말하지 않았음
- 차이도 1.66점으로 크지 않고 오차 범위가 겹침. Opus 5.5에서 Mythos 5.2로 오른 2.34점보다 작음
- 10월에 돌던 Fable 5.5 시험 소문도 그때 사람들이 본 게 지금의 5.2였을 수 있음
더 큰 게 온다는 쪽에 걸겠음
- 더 큰 게 온다고 봄. Anthropic은 항상 기대를 저버리지 않았음 (글쓴이 의견)
- 이번에도 점수를 16점 올리면서 정가는 100만 토큰당 $10·$50에서 $8·$40으로 내렸음
- 속도도 5.1보다 최대 30% 빠르다고 함. 제조사 수치임
- METR은 Anthropic 모델의 벤치마크 상승 속도가 2025년 10월 이후 1.9배로 빨라졌다고 추정함. 95% 신뢰구간은 1.5–2.8배임
- 빨라진 이유의 대부분은 Anthropic이 연구에 AI를 많이 쓴 덕으로 봄
- 이번 모델은 AI 개발에 바로 쓰이는 일부 능력을 학습 단계에서 일부러 Opus 5.5 수준으로 눌렀다고 밝혔음
- 반대로 볼 이유도 있음. METR은 가장 유용했던 증거 다수가 가려져 대중이 직접 판단하기 어렵다고 적었음
- 벤치마크 상승이 실제 업무 능력 상승보다 과장됐을 가능성도 METR이 직접 인정함
어차피 못 따라오니까 조금씩 푸는 듯
로켓은 나중에
- 어차피 못 따라오니까 미공개 모델을 놔두고 조금씩 푸는 듯함 (글쓴이 의견)
- 10월 28일 Gemini 4 Carbon이 59점으로 1등을 가져갔는데, 12일 만에 0.1 올린 모델로 되찾았음 (Google)
- CEO 에세이도 속도를 늦출 수 있는 폭은 미국 기업이 앞선 격차만큼이라고 적었음 (Dario Amodei)
- 다만 그 글이 말한 상대는 중국이고, 조금씩 푼다는 뜻은 아님
- 못 따라온다는 말에도 반례가 있음
| 항목 | Fable 5.2 | 경쟁사 최고 | 출처 |
|---|---|---|---|
| AA 지수 | 65 (max) | 60 (Carbon high) | AA |
| AA 문제 하나당 비용 | $26.54 | $7.76 (Carbon high) | AA |
| FrontierCode 2.0 코딩 | 49.1% | 42.8% (GPT-6 Astra) | Anthropic |
| 차트 읽기 Chartography | 73.4% | 72.5% (Carbon) | Anthropic |
| AutomationBench 업무 자동화 | 51.4% | 53.9% (Carbon) | Anthropic |
- 업무 자동화는 Carbon이 앞서고, 차트 읽기는 0.9%p 차이임
- Fable을 high로 낮추면 62점이라 Carbon과 2점 차임
- 65점의 값도 비쌈. 문제 하나당 비용이 Carbon의 약 3.4배이고, Fable 5.1 max의 $12.99보다도 약 2배임
- 쥐고 있는 이유가 여유뿐이라는 증거도 없음. S-1은 안전 평가 때문에 출시를 늦추거나 제한한 적이 있다고 적었음
그래서 앞으로는?
- 첫 번째로 볼 건 다음 번호임. 5.3이면 내 해석은 많이 약해지고, 5.5나 6이면 맞아 가는 것임
- 시점은 계산만 해 볼 수 있음. 5에서 5.1까지 84일, 5.1에서 5.2까지 69일이었음
- 같은 간격이면 2027년 1월 17일에서 2월 1일 사이임. 공식 일정은 아님
- 두 번째는 AA 점수임. 이 그림이 맞다면 다음 Fable은 65점에서 크게 뛰어야 함
- 세 번째는 경쟁사임. 이 그림이 맞다면 Google이나 OpenAI가 1등을 가져갈 때마다 Anthropic 신모델도 금방 따라 나와야 함
- 우리 AI 주식 대결의 Fable도 5.2로 바꿨음. 11월 14일 주간 회의부터 5.2가 결정함
Q&A 또 궁금한 것은?
- Q. 지금 바로 5.2로 바꿔야 함?
- Anthropic도 일상적인 코딩과 업무는 Opus 5.5부터 쓰라고 권함
- 앱과 Claude Code 기본값인 medium은 AA 56점이라 65점이 그대로 나오는 게 아님
- Q. Mythos 5.2가 숨겨 둔 5.5 아님?
- 아님. Fable 5.2와 같은 모델이고 안전장치와 사용 대상만 다름
- Q. 구독으로 쓸 수 있음?
- 쓸 수 있음. Fable이 포함된 유료 플랜에 출시 주간 추가 사용량을 줌
- Pro와 Team 표준 좌석은 주간 한도의 최대 50%까지 Fable에 쓸 수 있음