3줄 요약
- Meta가 10월 12일 Muse Wonder와 Muse Wonder Full을 내놨고, Wonder Full은 Artificial Analysis 지수에서 56점으로 Claude Opus 5.5(58점)보다 낮고 GPT-6 Astra(53점)보다 높음
- 회사별 최고 모델로 줄 세우면 Meta가 이 지수 2위지만, Wonder Full은 월 $50부터인 Muse Code 요금제에서만 쓸 수 있고 Meta 자체 표에도 지는 항목이 분명히 있음
- 나는 Claude를 쓰고 있고 당분간 그대로 가겠지만, 긴 코딩 작업용으로 Wonder Full은 한 달쯤 써볼 만해 보임
Wonder 다음이 Wonder Full, 소리 내서 읽어보면 앎
- 모델 이름은 Muse Wonder와 Muse Wonder Full임
- 큰 쪽을 소리 내서 읽으면 "원더풀"이 됨
- 개발자다운 유머 감각이 보이는 작명임
- Wonder가 기본 모델이고, Wonder Full은 Meta가 가장 성능 좋은 버전이라고 부르는 무거운 모델임 (모델 카드)
- 둘 다 글·이미지·영상·음성을 입력받아 글로 답하고, 컨텍스트는 100만 토큰임
- Meta가 내세운 기능은 대화가 바뀌어도 맥락을 이어 가는 Active Memory와, 막혀도 작업을 계속 밀고 가는 Active Focus임
56점이면 Claude와 OpenAI 사이임
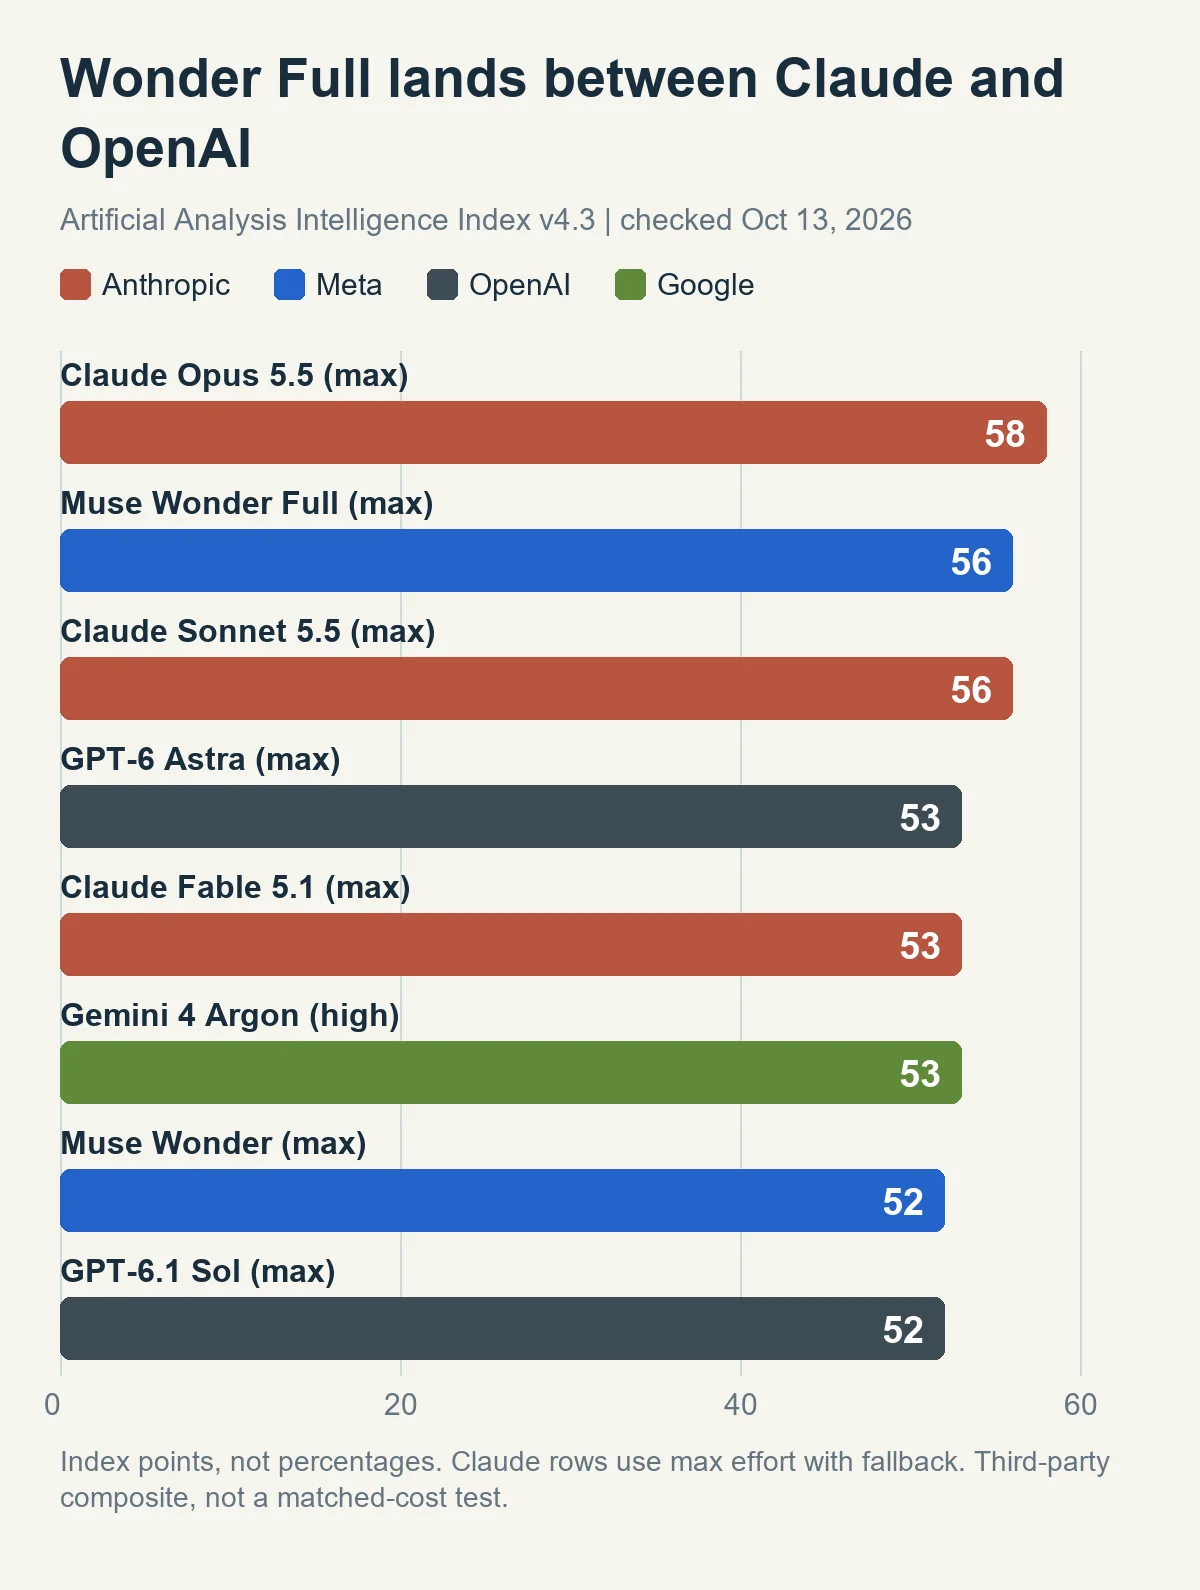
출처: Artificial Analysis 분석 글, 순위표, 2026년 10월 13일 확인
- 이 지수는 코딩부터 과학 문제까지 외부 평가 10개를 점수 하나로 묶은 것임
- Wonder Full은 56점으로 Claude Sonnet 5.5와 같고, Opus 5.5보다 2점 낮음
- OpenAI 최고 모델인 GPT-6 Astra는 53점으로, Gemini 4 Argon·Claude Fable 5.1과 같음
- 회사마다 제일 좋은 모델만 놓고 보면 1위 Anthropic, 2위 Meta임
- Artificial Analysis는 상승폭의 상당 부분을 환각 감소로 봄
- 환각률이 Muse Spark 1.3의 33%에서 Wonder Full 23%로 내려감
- 2주 전 2군 AI 글에서 Meta를 48점짜리 2군 선두라고 썼는데, 그 표현은 금방 낡아버림
Llama는 같은 지수에서 10점임
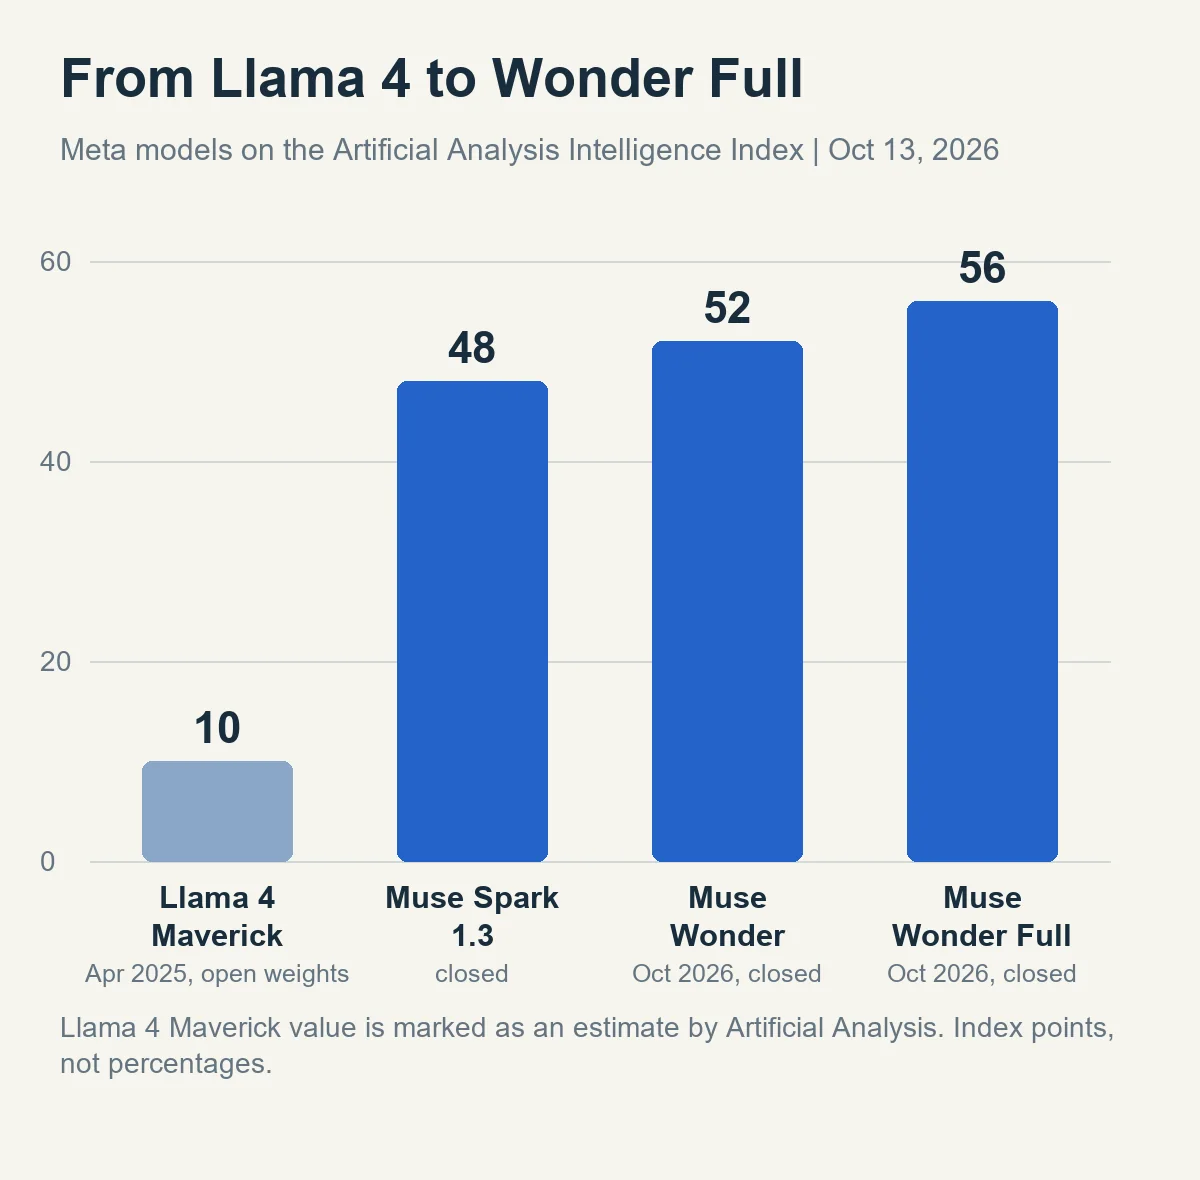
출처: Artificial Analysis Llama 4 Maverick 페이지(추정치 표시), Muse Wonder 분석 글, 2026년 10월 13일 확인
- 예전 Meta는 누구나 내려받아 돌릴 수 있는 공개 가중치 모델 Llama로 유명했음
- 마지막 대형 모델인 2025년 4월의 Llama 4 Maverick은 지금 지수에서 추정 10점임
- Meta는 2025년 8월부터 AI 조직을 다시 짰고, 거기서 Muse Spark와 이번 Wonder가 나옴
- 대신 Muse Wonder는 가중치를 공개하지 않음
- Meta API와 구독으로만 쓸 수 있음
- 오픈소스 기여로 알려졌던 회사가 약 14개월 만에 이 차트 2위 회사가 됐다는 건 놀라운 성과임
Meta 자체 표에서도 긴 코딩은 이기고 몇 개는 짐
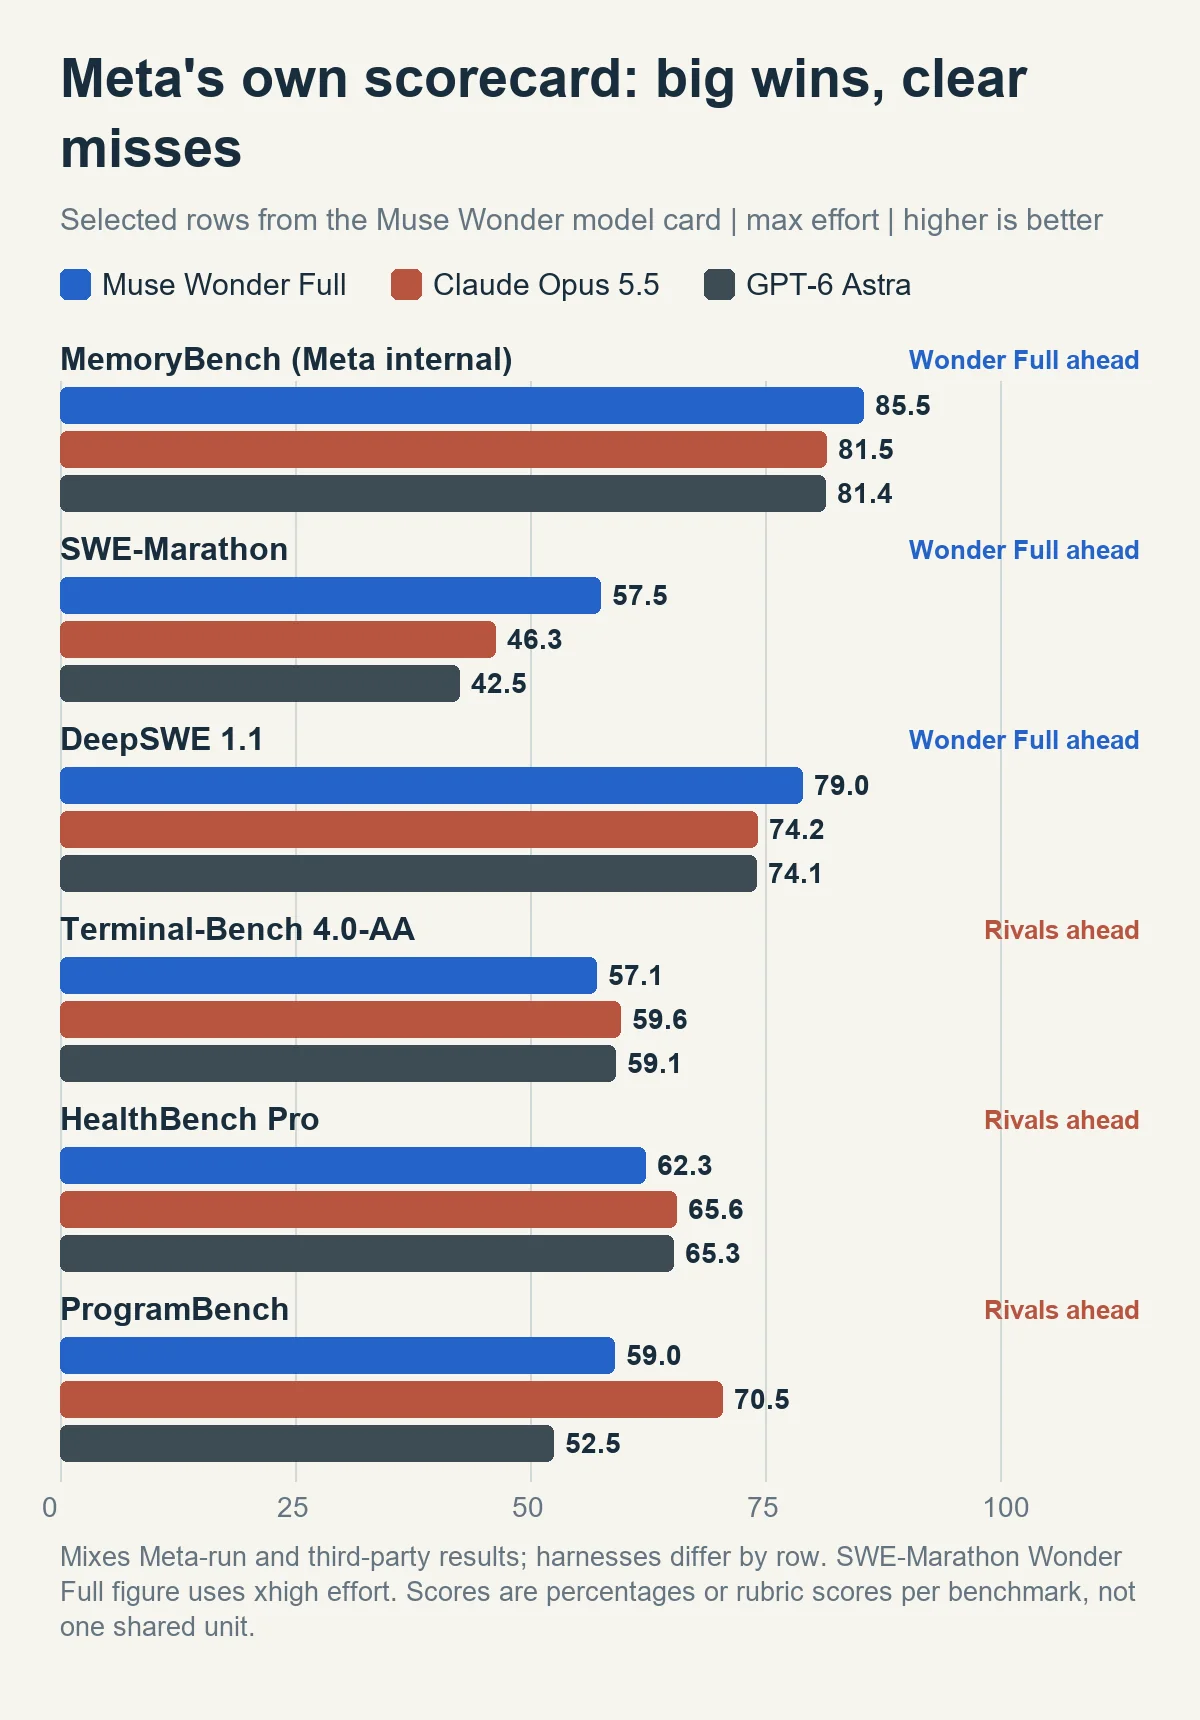
출처: Muse Wonder 모델 카드 벤치마크 표, max effort; Meta가 고른 비교
- 제조사가 만든 성적표라, 스스로 인정한 패배 쪽이 더 쓸모 있음
- 아주 긴 코딩 프로젝트를 보는 SWE-Marathon에서 Wonder Full은 57.5점으로 Opus 5.5(46.3점)를 앞섬
- 다만 이 항목은 모델마다 쓴 도구(Codex, Claude Code)가 다르고 Wonder Full만 xhigh 설정이라, 같은 조건 비교는 아님
- MemoryBench는 85.5점으로 Opus(81.5점)보다 높지만, Meta가 직접 만든 평가임
- Terminal-Bench 4.0, HealthBench Pro, ProgramBench는 Opus 5.5가 앞섬
- ProgramBench는 격차가 11.5점이나 됨
- Meta는 3D·공간 추론을 알려진 약점으로 적어 둠
Wonder는 Opus와 같은 값, Full은 요금제가 필요함
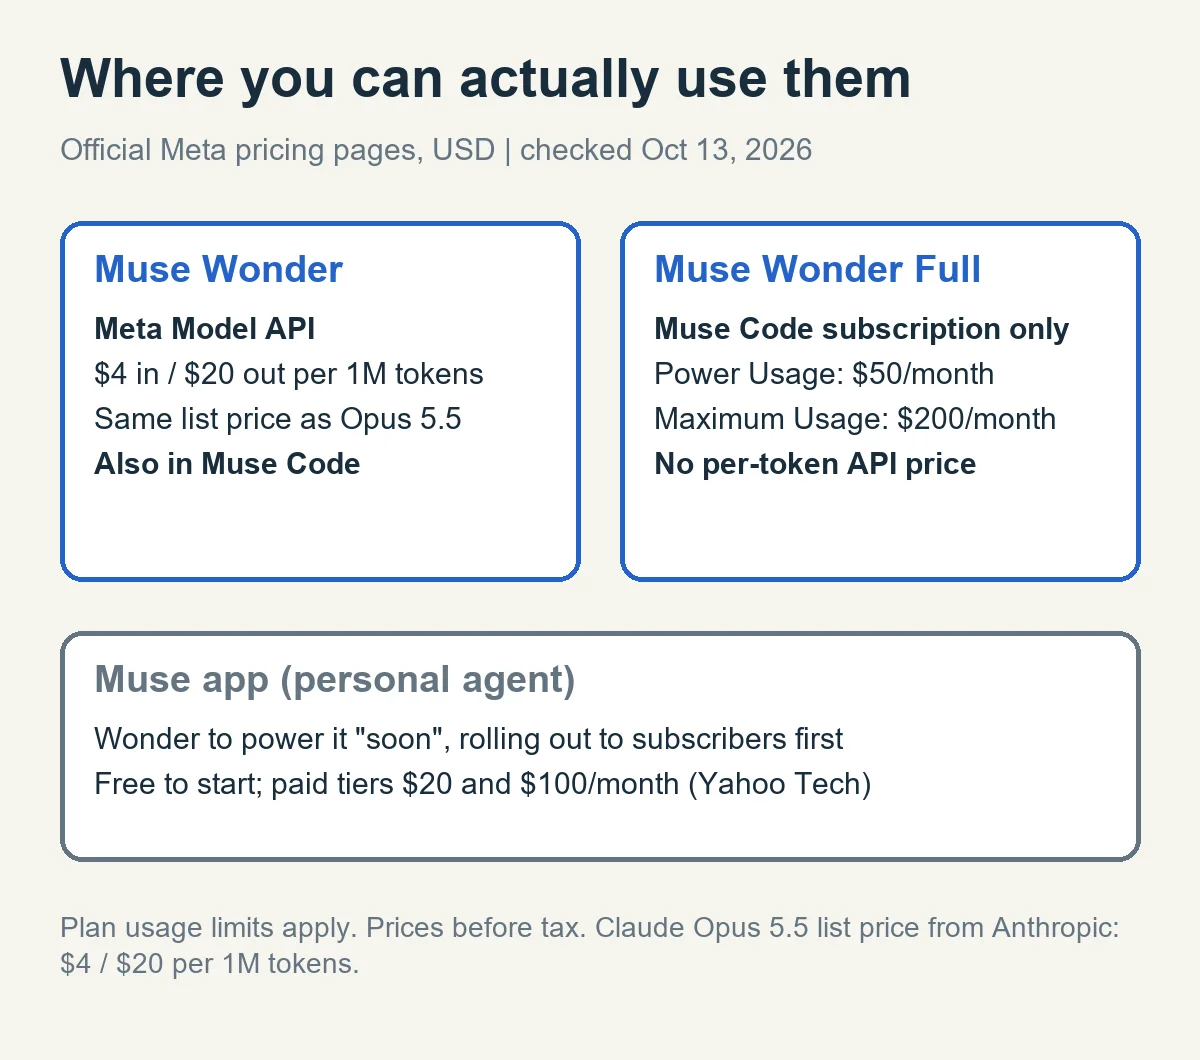
출처: Meta 모델 요금, Anthropic 요금, Yahoo Tech; USD, 세금 별도, 2026년 10월 13일 확인
| Muse Wonder | Muse Wonder Full | Claude Opus 5.5 | |
|---|---|---|---|
| AA 지수 | 52 | 56 | 58 |
| 100만 토큰당 API 요금(입력 / 출력) | $4 / $20 | API 요금 없음 | $4 / $20 |
| AA 지수 과제 하나당 비용 | $4.52 | 없음 | $5.98 |
| 쓸 수 있는 곳 | Meta Model API, Muse Code | Muse Code 월 $50·$200 | Claude API, 구독 |
- Wonder의 토큰 정가는 Opus 5.5와 똑같은데, 지수는 6점 낮음
- 대신 Artificial Analysis 측정에서 토큰을 덜 써서, 과제 하나당 비용은 $4.52로 Opus($5.98)보다 적었음
- Wonder Full은 토큰당 요금이 없음
- 월 $50 Power 요금제나 $200 Maximum 요금제에 들어 있음
- 결국 "원더풀"이라는 이름이 붙은 쪽은 개발자가 API로 바로 부를 수 없는 모델임
비서 앱 Muse가 먼저 사람을 모았음
- Meta의 개인 에이전트 앱 Muse는 9월 8일 출시됐고, 9월 18일 미국 App Store 무료 아이폰 앱 1위에 올랐음 (Yahoo Tech)
- 같은 기사는 Sensor Tower 자료를 인용해, 첫 10일 미국 다운로드를 73만 건 이상으로 봄
- Google Play에서는 생산성 부문 338위에 그쳤음
- 다운로드 수만으로는 계속 쓰는 사람이 얼마나 되는지 알 수 없음
- Meta는 곧 Wonder를 Muse에 넣겠다고 했고, 구독자부터 적용함
- 이미 깔아 둔 앱에 훨씬 센 모델을 얹는 순서라, 여러모로 잘하고 있다는 생각임
나는 Claude파지만 Wonder Full은 궁금함
- 지금은 Claude를 쓰는데, Meta 모델 중 써보고 싶어진 건 이번이 처음임
- 써본다면 Muse Code $50 요금제로 한 달, Meta 표에서 제일 강해 보인 긴 코딩 작업에 돌려볼 생각임
- 아직 Wonder도 Wonder Full도 직접 써보진 않았고, 위 내용은 전부 공개된 결과임
커뮤니티 반응
- Hacker News의 한 이용자는 Opus 5.5에만 지는 Artificial Analysis 2위면 "정말 나쁘지 않다"고 평가함 (Hacker News)
- 다른 이용자는 Meta 홍보 페이지의 점수가 상위 요금제에서만 쓰는 Wonder Full 것이고, API 요금은 Wonder 기준이라고 짚음 (Hacker News)
- 한 이용자가 이미지를 HTML로 옮기는 시험을 해 보니 Opus 5.5보다 훨씬 못했고 Sonnet·Haiku에 가까웠다며, 시각 처리가 아직 덜 익은 것 같다고 추측함 (Hacker News)
- 하위 Muse Code 요금제 구독자는 작은 Wonder 요청 두 번에 주간 한도의 4%가 사라져 Muse Spark 1.3으로 돌아갔다고 함 (Hacker News)
Q&A 또 궁금한 것은?
- Q. Wonder Full이 Claude Opus 5.5보다 좋음?
- Artificial Analysis 지수로는 56점으로 Opus(58점)보다 낮음, Meta 자체 표에서는 긴 코딩·기억에서 이기고 터미널·의료·ProgramBench에서 짐
- Q. Llama처럼 내려받아서 돌릴 수 있음?
- 안 됨, Wonder는 Meta API와 Muse Code로, Wonder Full은 Muse Code 요금제로만 제공됨
- Q. Muse Wonder는 싼 Opus임?
- 토큰 정가는 같음, 토큰을 덜 써서 과제당 비용은 낮게 측정됐지만 점수도 낮음
- Q. Muse 앱은 미국 밖에서도 됨?
- 출시 기사는 미국의 iOS·Android·WhatsApp·웹만 다룸, 다른 시장 출시는 확인하지 못했음