3줄 요약
- Artificial Analysis(AA)가 10월 27일 지수 v5를 내놨고, 이제 점수의 60%가 문제나 정답을 공개하지 않는 시험에서 나옴
- 안 보이는 시험은 미리 공부할 수가 없으니 벤치마크 튜닝으로 점수 부풀리기가 어려워짐. AA도 비공개 데이터가 평가를 조작할 여지를 줄인다고 직접 밝힘
- Kaggle의 비공개 리더보드와 같은 방식이라 앞으로 AA 점수는 더 믿을 만해 보임. 다만 비공개 부분은 AA 밖에서 아무도 다시 돌려볼 수 없음
v5는 점수의 60%를 숨겼음
- AA 지수는 지식 업무·코딩·과학·일반 지식 네 분야, 9개 시험을 25%씩 섞은 종합 점수임 (AA 방법론)
- 나는 AI 성능을 볼 때 이 지수 하나만 봐서, 이게 바뀌면 신모델 소식을 읽는 방식도 같이 바뀜
- 이번 v5의 핵심은 새 시험보다 시험지를 어디에 두느냐임
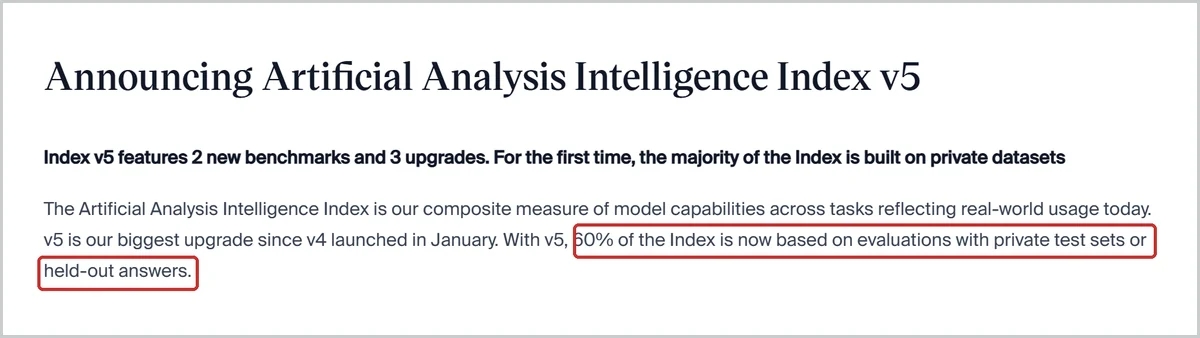
출처: Artificial Analysis — Intelligence Index v5 발표, 2026년 10월 27일, 빨간 테두리는 HSL 추가
- 비공개라는 건 문제, 아니면 최소한 정답과 채점용 테스트를 공개하지 않는다는 뜻임
- 비공개 비중은 빠르게 늘었음. v4.1에서 20%, 9월 v4.2에서 40%, 이번에 60%임 (AA v4.2)
- 새로 들어온 Cognition의 FrontierCode 2.0은 실제 오픈소스 코딩 과제 132개이고, 관리자가 그 수정을 받아 줄지로 채점함
- AA는 이 과제들을 "오염을 막으려고" 비공개로 둔다고 적었음
- 터미널에서 과학 연구 과제 70개를 푸는 Terminal-Bench-Science도 새로 들어왔고, SciCode 등 예전 시험 3개는 빠졌음
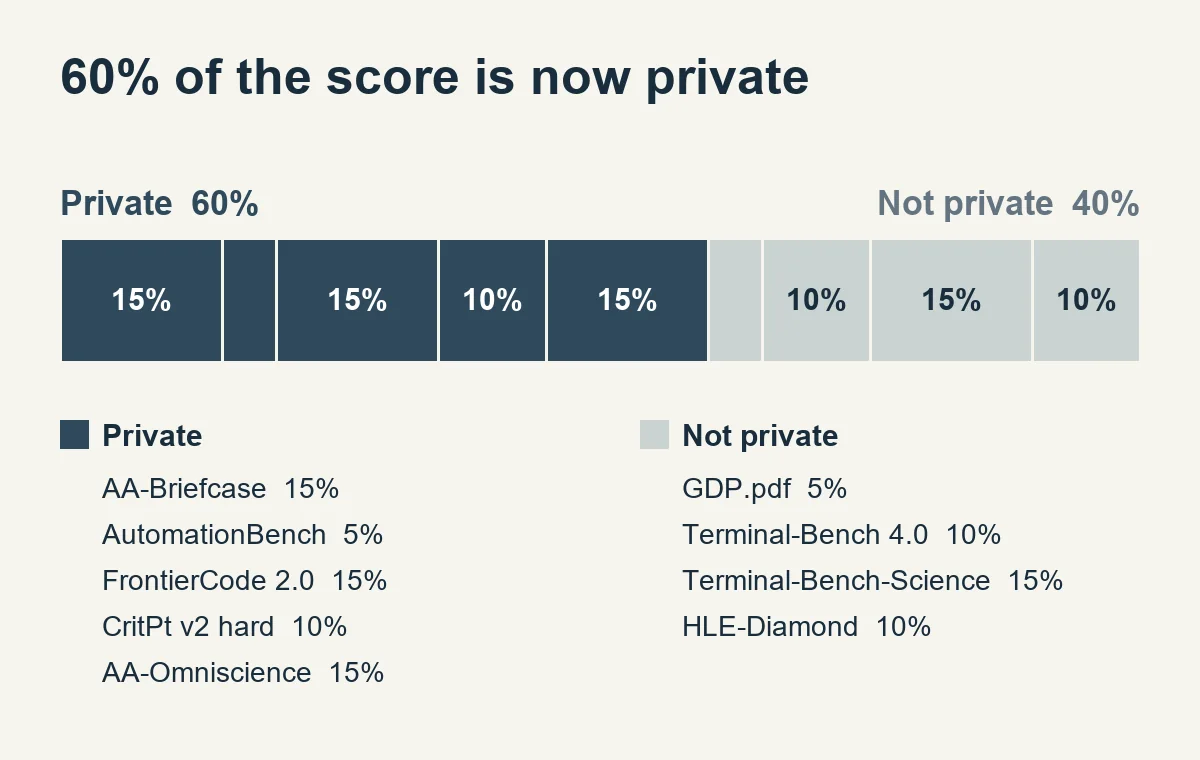
HSL 제작 — AA 방법론 페이지의 가중치와 비공개 표시, 2026년 10월 29일 확인
- 발표 당일 1등은 58점 Claude Opus 5.5, 그 뒤가 57점 GPT-6 Astra와 55점 GPT-6.1 Sol이었음
- 하루 뒤 Gemini 4 Carbon이 59점으로 1등을 가져감
시험지를 숨기는 이유: 점수 부풀리기
- 공개 벤치마크엔 약점이 있음. 문제가 인터넷에 풀리면 학습 데이터에 섞이거나, 모델을 그 문제에 맞춰 다듬을 수 있음
- 그러면 점수는 오르는데, 모델은 과목이 아니라 기출문제를 공부한 셈이 됨
- AA도 비공개 데이터가 "평가를 조작할 여지를 줄인다"고 직접 적었음 (AA v4.2)
- 그래서 제목의 "금지"는 정확히 말하면 규칙으로 막은 게 아님. 문제가 안 보이니 맞춰서 최적화할 대상이 없어진 것임
- 이 문제로 가장 시끄러웠던 곳은 사람들이 익명 답변 두 개 중 하나에 투표하는 LM Arena였음
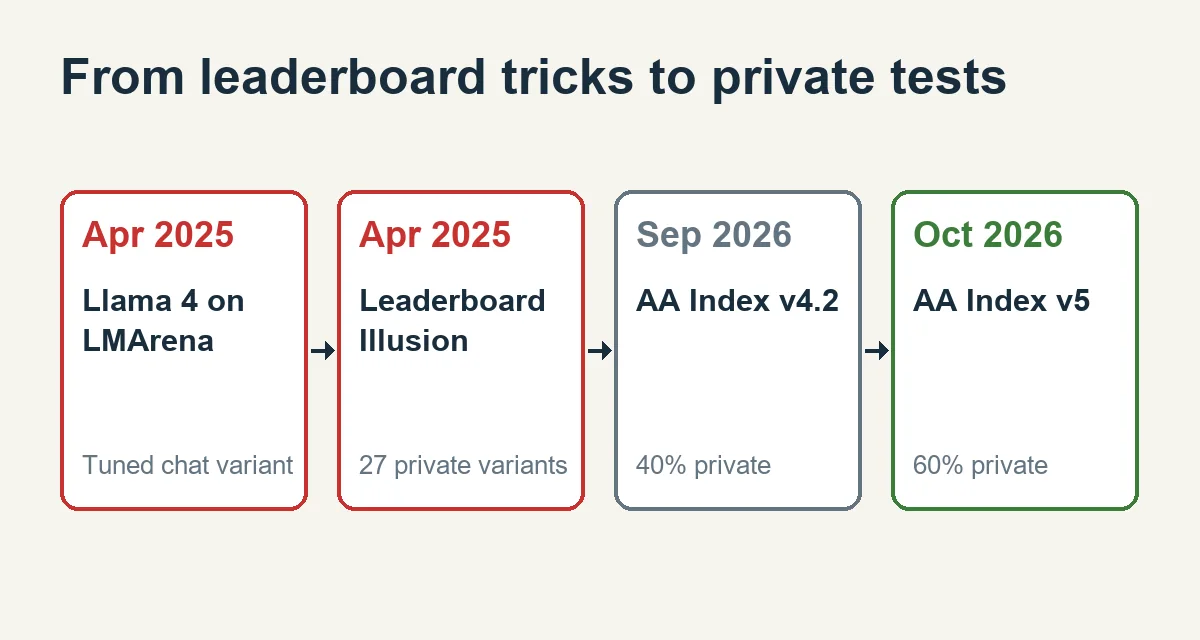
HSL 제작 — Meta, Leaderboard Illusion, AA v4.2, AA v5
- 2025년 4월 Meta는 Llama 4 Maverick의 Arena 점수 1417점을 내세웠는데, "실험용 채팅 버전"이 받은 점수였음 (Meta)
- LMArena는 그게 사람들 취향에 맞춰 다듬은 맞춤 모델이라는 걸 Meta가 더 분명히 밝혔어야 했다며, 실제 공개 버전을 순위표에 따로 올렸음 (LMArena 성명, Simon Willison 인용)
- 그 공개 버전은 GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro보다도 아래에 자리 잡았음 (TechCrunch)
- 몇 주 뒤 "The Leaderboard Illusion" 논문은 Meta가 Llama 4 전에 비공개 변형 27개를 시험했다고 세고, 제일 좋은 것만 공개하면 점수가 부풀려진다고 주장함 (arXiv)
- Arena는 그 효과가 그렇게 크지 않다며, 비공개 시험 50번 뒤에도 약 +11 Elo 정도라고 반박함 (Arena)
- 나도 예전엔 AA랑 LM Arena를 같이 봤는데, 사람 투표라 인기 편향이 좀 들어가는 것 같아서 지금은 AA 하나만 봄
Kaggle 비공개 리더보드랑 같은 방식
- 데이터 분석 대회는 이 문제를 오래전에 풀었음
- Kaggle에선 대회 중에 보이는 순위표가 시험 데이터 일부로만 매겨지고, 최종 순위는 나머지 데이터로 정함 (Kaggle 문서)
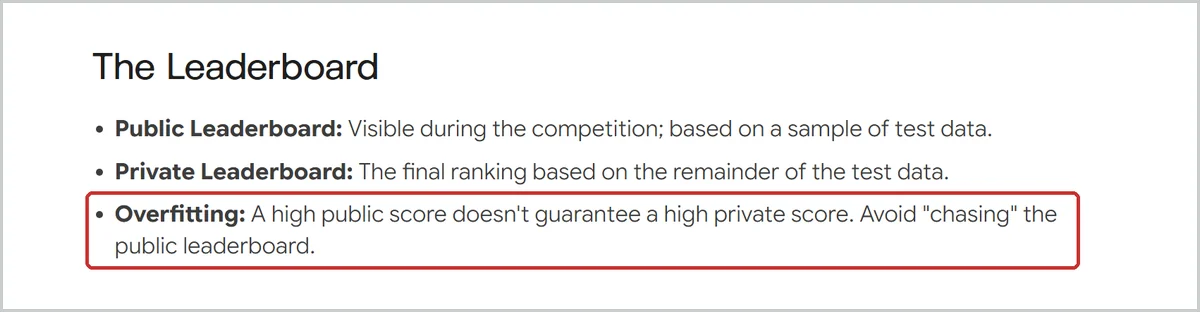
출처: Kaggle — Competitions 문서 The Leaderboard, 빨간 테두리는 HSL 추가
- Kaggle은 공개 점수가 높다고 비공개 점수가 높은 건 아니라며, 공개 순위표를 쫓지 말라고 경고함
- 나도 데이터 분석 대회에 나가 보면 과적합을 막으려고 진짜 순위를 정하는 시험은 마지막에 공개하는데, 공정한 방식이라고 생각함
- AA의 비공개 시험이 그 최종 순위표 역할을 하는 셈임. 다른 점은 결과를 한 번이 아니라 매번 보여 준다는 것임
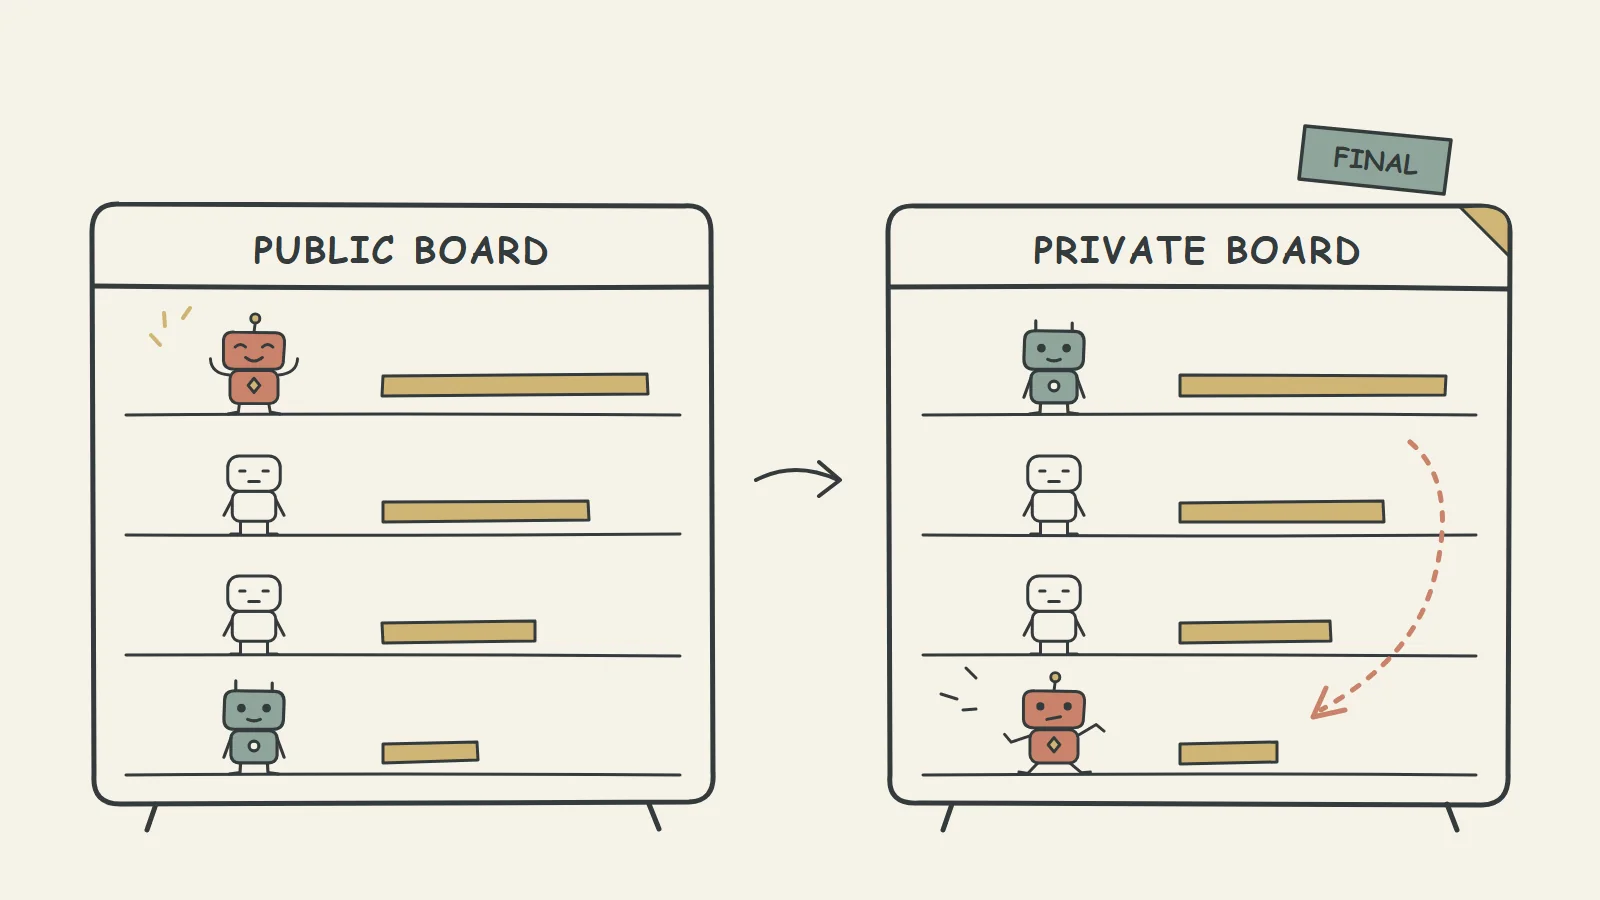
공개 순위표 1등, 최종 순위표 꼴찌
그럼 AA 점수 더 믿어도 됨? 응, 단서 세 개 붙여서
- 아주 좋은 방식이라고 생각하고, 앞으로 AA 점수는 더 믿고 볼 생각임
- 그래도 알고 볼 한계가 세 가지 있음
- 비공개 부분은 AA 밖에서 아무도 다시 돌려볼 수 없음. 시험을 믿던 게 출제자를 믿는 걸로 바뀜
- 문제를 숨겨도 점수를 매번 알려 주면 신호가 조금씩 샘. 한 연구의 모의 공격은 모델을 섞고 점수 좋은 것만 남기는 것만으로 시험의 설계상 최고점을 넘겼음 (CapBencher)
- 지수의 40%는 여전히 공개임. Terminal-Bench 4.0, Terminal-Bench-Science, HLE-Diamond, GDP.pdf가 그쪽임
- v5로 오염이 실제로 얼마나 줄었는지 잰 자료는 아직 없음. 그건 AA의 설계 목표이지 측정 결과는 아님
- 1–2점 차이는 여전히 동점으로 보는 게 맞다고 봄
| AA 점수를 볼 때 | 내가 확인하는 것 |
|---|---|
| 두 모델이 1–2점 차이 | 동점으로 보고 가격·속도를 비교 |
| 종합 점수가 크게 뜀 | 9개 시험 중 뭐가 움직였는지, 비공개인지 공개인지 |
| 코딩에 쓸 모델 | FrontierCode, Terminal-Bench 같은 코딩 시험만 따로 |
| 예전 점수와 비교 | 같은 지수 버전끼리만, v5 숫자는 v4와 다름 |
커뮤니티 반응
- Hacker News의 hgoel은 v5에서 1점 차이가 실제로 무슨 의미인지, 자주 바뀌는 시험을 왜 비공개로 두는지 물음 (Hacker News)
- v5 전인 9월 r/LocalLLaMA 스레드에서 feng_sg는 모델 가중치를 공개해도 비공개 AA-Briefcase 점수는 밖에서 재현할 수 없다고 지적함 (Reddit)
- 같은 스레드의 Antblue는 공개된 샘플 시나리오와 AA 평가 도구로 결과를 뒷받침할 수 있다고 반박함 (측정 없는 추측) (Reddit)
- 4월 r/LocalLLaMA 스레드의 iperson4213는 문제를 숨겨도 정답이 담긴 원본 코드가 공개돼 있으면 소용없다고 경고함 (측정 없는 추측) (Reddit)
Q&A 또 궁금한 것은?
- Q. v4 점수랑 v5 점수를 비교해도 됨?
- 안 됨. AA가 시험과 가중치를 바꿔서 모든 모델 점수가 움직였음. 같은 버전끼리만 비교해야 함
- Q. 비공개 시험이면 꼼수가 아예 불가능함?
- 아님. 가장 쉬운 길을 막은 것뿐이고, 반복되는 점수 피드백이나 유출된 원본 자료로는 여전히 이득을 볼 수 있음
- Q. 그냥 LM Arena 보면 안 됨?
- Arena는 사람들이 어떤 답을 더 좋아하는지를 재서 말투나 인기가 섞임. 일을 얼마나 정확히 하는지와는 다른 질문임
- Q. AA 점수가 높으면 나한테도 제일 좋은 모델임?
- 꼭 그렇진 않음. 지수가 주로 영어·텍스트 위주라, 내 작업으로 직접 써보는 것도 필요함